ソフトウェアテストにおけるAI: 今できること
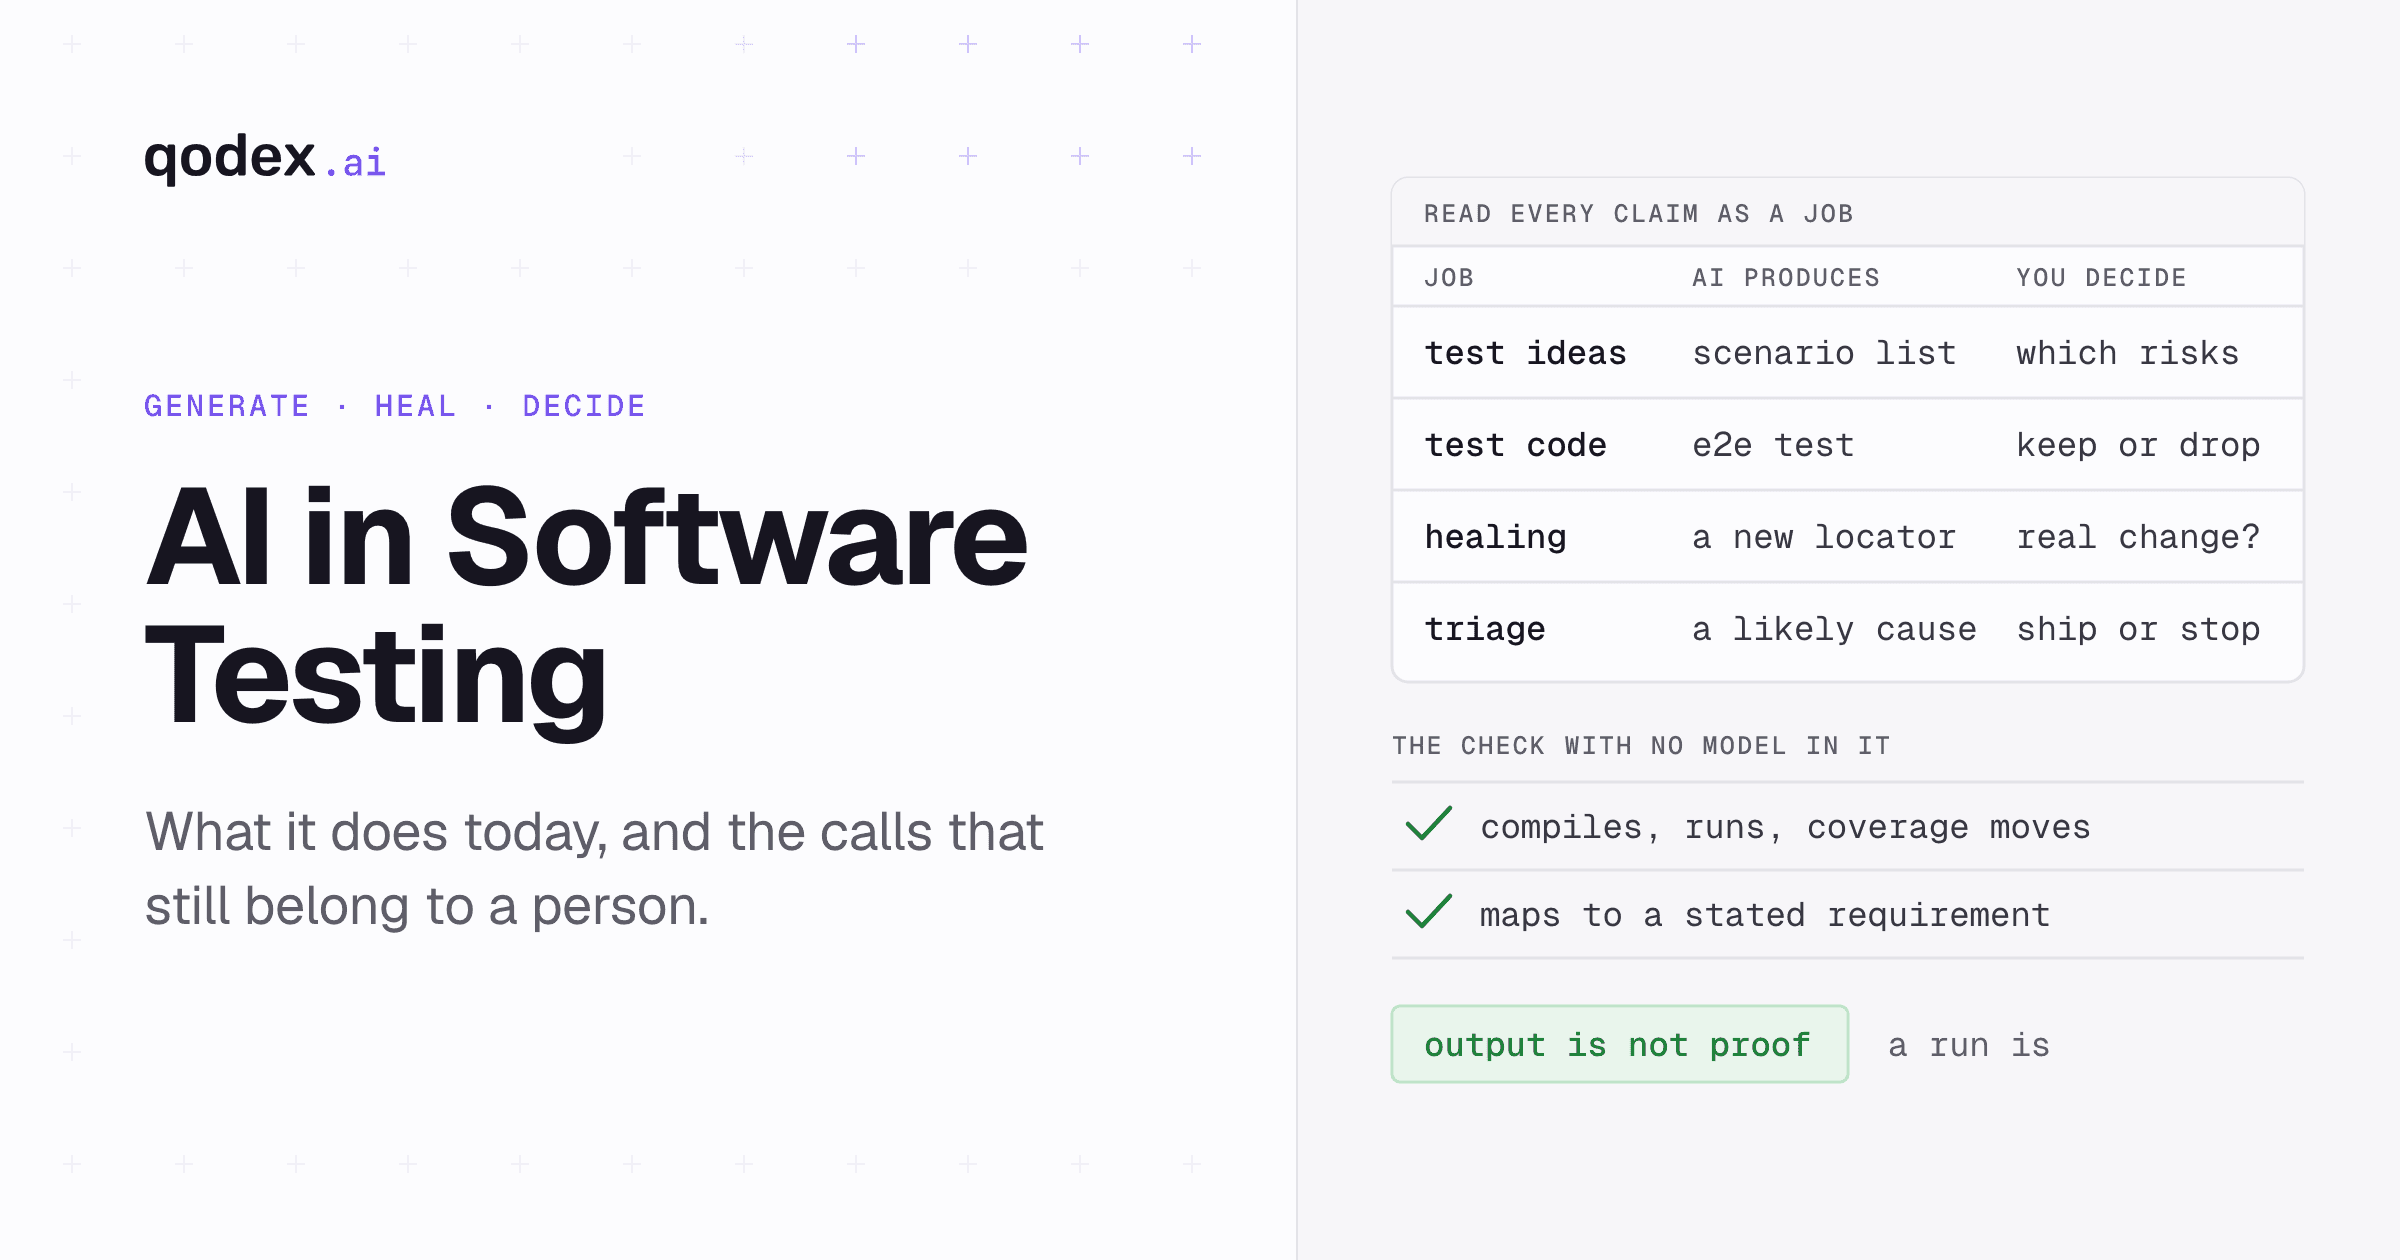
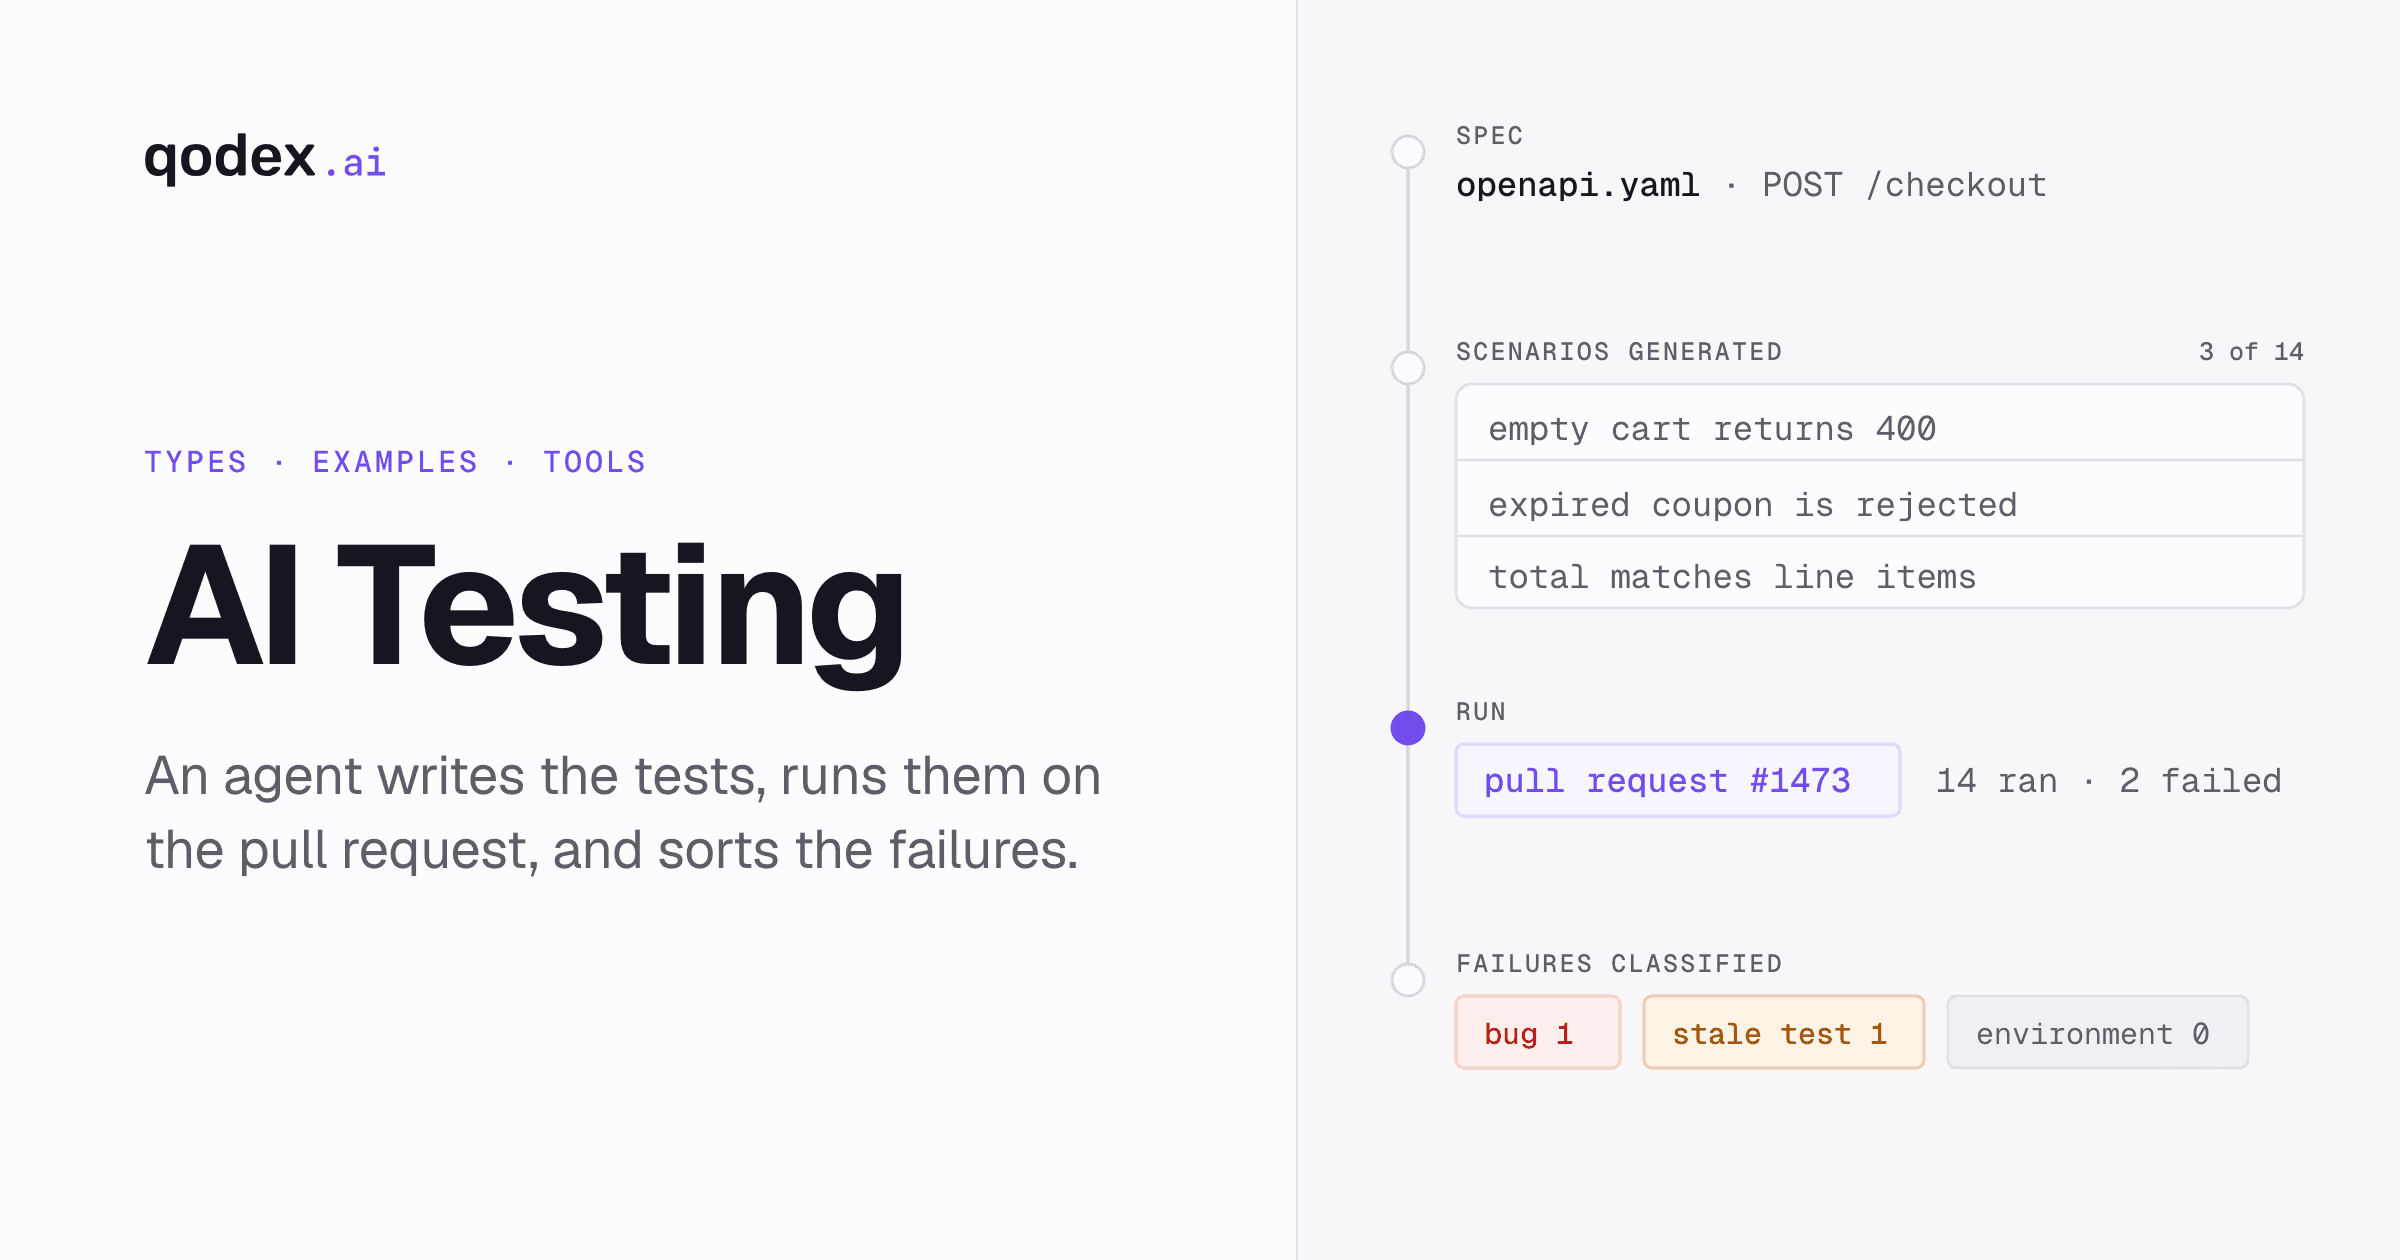
ソフトウェアテストにおけるAIは、テストケースの設計、データやスクリプトの生成、実行するテストの選択、UIが変わったときの自動化の追従、ビジュアル結果の比較、失敗の調査を手助けします。最もうまく機能するのは、決定的なチェックを取り巻くアシスタントとしてであり、ソフトウェアが十分に良いかを判定する審判としてではありません。リスクを決め、あいまいな振る舞いを読み解き、機密データを守り、証拠がリリースを裏付けるかを判断するのは、引き続き人です。
フローを一文で説明してください。Qodexが実際のアプリを操作し、壊れた箇所のスクリーンショットを持ち帰り、その実行をあなたのものになるPlaywrightのコードとして保存します。
このページでは、この技術が今日実際に何をしているかを説明します。製品を比較したい場合は、おすすめのAI QAツールのまとめが、mablのようなノーコードプラットフォームやその近い競合を含めて比較しています。AI QAガイドは、その土台にある機械学習、言語、画像認識の技術を扱い、AIリグレッションテストは、これらがリグレッションスイートの中で何を意味するかを扱っています。このページは作業のレベルにとどまります。AIが何をし、何がそれを確認し、何を人が引き続き判断するかです。
テストのどこにAIを使うかの選び方
| 質問 | なぜ重要か | 良い状態とは |
|---|---|---|
| 今月いちばんコストがかかっている悩みは何か? | AIが最も役立つのは特定のボトルネック | 一つ選ぶ: テストの作成、不安定なテストの保守、遅いパイプライン、ノイズの多いトリアージ |
| 出力は手元に残せるコードか? | ベンダー独自の形式に閉じたテストは、レビューも移行も難しい | 標準フレームワークで書かれた読みやすいスクリプトを、gitで管理する |
| 再実行のたびにモデルを呼び出すか? | 毎回モデルを呼ぶと、コストも結果もばらつく | モデルはテストを一度だけ書き、再実行は固定のスクリプトを再生する |
| AIが書いたものを誰が承認するか? | 生成されたテストは、何も確認せずに通ることがある | 新しいテストは、人が昇格させるまで下書きとして扱う |
| どんなデータを見るのか? | ステージングのデータや認証情報が社外のネットワークに出る | SOC 2またはISO 27001、データ保持の管理、必要なら自社のモデルキー |
ソフトウェアテストにおけるAIとは
同じ名前で呼ばれる仕事が2つあります。一つはAIを使ってテスト作業をすること。もう一つは、AIを組み込んだ製品をテストすることです。ISTQBはこの2つを分けており、この区別はベンダーのページを読むときに役立ちます。
テストにAIを使う。 CT-GenAIのシラバスは、テスターが要件分析、テスト設計、自動化、レポートに生成AIを使うことを扱い、管理すべきリスクとして、ハルシネーション、推論の誤り、バイアス、データのプライバシーとセキュリティ、エネルギー消費を挙げています。2026年9月14日確認。
AIシステムをテストする。 CT-AI v2.0のシラバスは、機械学習システムや大規模言語モデルを含むAIベースのシステムのテストを扱い、入力データのテスト、モデルのテスト、ML開発のテストを含みます。テスト対象システムの確率的な振る舞い、非決定性、データ、モデル、品質特性を扱っており、このページとは別の問題群です。2026年9月14日確認。
このページが扱うのは1つ目の仕事です。その中でも、4つの異なる技術がAIと呼ばれており、それぞれ振る舞いが違います。
生成による支援。 言語モデルが計画、ケース、スクリプト、データ、要約の下書きを作ります。出力は確率的なので、同じプロンプトでも明日は違うものが返ってくることがあります。
分類と優先順位付け。 モデルが変更に対してテストを順位付けし、似た失敗をまとめ、不安定に見えるパターンに印を付けます。
コンピュータビジョン。 DOMの属性を一つずつ検証する代わりに、描画されたページを比べてレイアウトや描画の違いを見つけます。
実行時エージェント。 モデルがアプリケーションを操作し、次の手順を決め、固定のスクリプトを再生するのではなく、見えたものに反応します。
ある機能が4つのうちどれを使っているかを尋ねてください。その答えから、どれだけ再現性があるか、どう検証するか、実行にいくらかかるかが予測できます。
テストのライフサイクル全体でAIがすること
AIテストに関する主張は、入力、出力、モデルを使わない確認、人に残る判断を持つ一つの作業として読むのが有効です。次の表は、AIが今日関わっている作業についてそれを整理したものです。
| テスト作業 | AIに必要な入力 | AIが生み出すもの | 決定的なチェック | 人の判断 | 最も向いている場面 | 主なリスク |
|---|---|---|---|---|---|---|
| 要件をテストのアイデアに変える | 要件、ユーザーフロー、アプリへのアクセス | エッジケースを含むシナリオ一覧 | 各シナリオが明記された要件に対応している | このリリースでどのリスクが重要か | 新機能や文書の乏しい機能 | もっともらしいが本当のリスクを外したシナリオ |
| テスト計画の下書き | 範囲、環境、元になるテスト | 手順とデータを含む読みやすい計画 | 計画を一度手作業で最後まで実行する | 領域ごとのカバレッジと深さ | よく知っているアプリのリグレッション計画 | 完全に見えて実は不完全なカバレッジ |
| 実行可能なテストの生成 | ソースコード、計画、例 | ユニットテストやエンドツーエンドテストのコード | コンパイル、実行、カバレッジの増分、アサーションのレビュー | そのテストをスイートに入れるべきか | ユニットテストと正常系のフロー | 何も検証せずに通るテスト |
| テストデータの作成 | スキーマ、制約、量 | 合成レコードとフィクスチャ | スキーマと制約の検証 | どの本番データを社外に出してよいか | 負荷用データとエッジケースのレコード | 本物のデータがプロンプトに漏れる |
| 実行時にアプリケーションを操作する | アプリへのアクセス、言葉で書いた目標 | 完了または失敗した実行 | スクリーンショット、ネットワークログ、終了コード | ずれがバグかどうか | 探索とテストの最初の作成 | スクリプトより遅く、再現性が低い |
| 壊れた自動化の修復 | 失敗したテスト、ページの状態、履歴 | ロケーターや手順の変更案 | 古いビルドでは失敗し、新しいビルドでは通る | 受け入れる、却下する、調べる | 見た目や構造のUI変更 | 気づかないうちに違う要素に一致してしまう修復 |
| ビジュアル出力の比較 | ベースラインと現在の描画 | 差分のある領域と判定 | 人が承認したベースライン | その違いが意図したものか | レイアウトやブラウザ間のリグレッション | ノイズを抑えすぎて本当の破損を見逃す |
| 変更に対するテストの選択 | 差分、履歴、カバレッジデータ | 今実行する、順位付けされた一部のテスト | 保険としてスケジュールで回すフルスイート | その一部でマージに十分か | 大規模なスイートと遅いパイプライン | 順位付けされた範囲の外でのリグレッションの見逃し |
| 失敗のトリアージと要約 | ログ、トレース、スクリーンショット、履歴 | まとめた失敗と、原因の仮説 | 失敗の生の成果物が証拠であり続ける | 本当の根本原因と修正 | 同じ失敗が繰り返されるノイズの多いCI | 自信たっぷりだが間違っている要約 |
計画はこれらすべての上流にあり、その進め方はテスト計画書の作成のガイドで扱っています。API側では生成が最も成熟した用途で、AIで30分でAPIテストを自動化するや、より広いAPIテストガイドで詳しく説明しています。選択とトリアージはパイプラインの中で効果を発揮し、そこからはAIリグレッションテストと最新のCI/CDのトレンドが話を引き継ぎます。
テスト生成: 役に立つ出力は証明ではない
独立した証拠が公開されているのは生成の分野だけで、その証拠も全体的なものではなく具体的なものです。
Metaは自社のTestGen-LLMをInstagramのReelsとStoriesに適用しました。生成されたテストケースのうち、75%が正しくビルドでき、57%が安定して通り、25%がカバレッジを高めました。これは一つの導入事例での評価結果であり、自社のコードで期待すべき成功率ではありません。2026年9月14日確認。
カバレッジの穴をプロンプトに戻すPython向けテスト生成ツールのCoverUpは、モジュールごとの行とブランチのカバレッジの中央値で80%を達成しました。CodaMosaは47%でした。全体では89%で、MuTAPの77%を上回りました。これもオープンソースのモジュールでのベンチマークの数値です。2026年9月14日確認。
どちらの結果も同じように読んでください。モデルは大量のテストコードを素早く書けますが、そのかなりの部分は誤っているか、弱いか、重複しています。それでも問題ありません。フィルターは安価で機械的だからです。
コンパイルできる。 ビルドできないものは、人が見ることなく捨てます。
実行でき、繰り返し通る。 候補はそれぞれ何度か実行します。結果が揺れるものは捨てます。
カバレッジを増やす。 スイートに欠けていた行やブランチをカバーする場合だけ、候補を残します。
何かを検証している。 結果を確認せずにコードを実行するだけのテストは、誤ったシグナルです。アサーションの設計はそれ自体が一つの技術で、Playwrightのアサーションのガイドで扱っています。
人が承認する。 その機能を知っている人が、マージを止められるようになる前にテストを読みます。
生成はコードより前の段階からも始まります。Playwrightのプランナーエージェントは、動いているアプリを探索し、そこから何かを生成する前に読めるMarkdownの計画を書きます。作業には明確な依頼と元になるテストが必要です。これにより、テスト生成が始まる前に人がレビューする機会ができます。出典: Playwright Test Agents、2026年9月14日確認。
ツールはこうしたフィルターを組み込むようになってきています。GitHubはユニットテストの生成をCopilotのワークフローとして文書化しており、Playwrightのジェネレーターエージェントは、テストを書きながら、動いているアプリに対してセレクターとアサーションをその場で検証します。どちらも2026年9月14日確認。どちらもレビューの手順をなくすものではありません。
自己修復とエージェントによる実行
2つの機能がよく混同されます。どちらも実行時にモデルを使うからです。
AI機能を作ると、2つ目のQAの問題が生まれます。ツール、複数ステップの判断、ガードレール、繰り返しの実行にわたってAIエージェントをテストすることです。
自己修復は、UIが変わったことで壊れた自動化を直します。ボタンの属性が変わると、モデルが周囲の属性、表示されているテキスト、視覚的な文脈を使って、代わりのロケーターや手順を提案します。mablは、テストを自律的に更新し、文脈が必要なときはある操作の理由を人に尋ねるエージェントを説明しています。テスト保守を最大95%削減するという主張はベンダー自身の数値で、方法は公開されていません。Applitoolsは、自社のロケーターが視覚的・意味的な手がかりで変更された要素を見つけ、Visual AIが描画やレイアウトのリグレッションを検出すると述べています。これもベンダーの主張です。どちらも2026年9月14日確認。
正直に言えば、自己修復が変えるのはテストが要素を見つける方法であって、テストが検証する内容を変えてはいけません。似ているが別の要素に一致するよう修復されたロケーターは、緑のビルドを嘘にしてしまいます。すべての修復をプルリクエストとして扱ってください。修復は提案され、レビューされ、元に戻せるものであり、修復が有効と認められる前に、そのテストが壊れたビルドで失敗する必要があります。ベンダーごとの仕組みは、それぞれがレビューと取り消しのために何を公開しているかを含めて、AIリグレッションテストで詳しく扱っています。
エージェントによる実行は別物です。ここではモデルが目標に向けてアプリを操作し、次の手順を毎回決めます。Playwrightはプランナー、ジェネレーター、ヒーラーのエージェントを提供しており、バージョン1.56で追加されました。リリースノート上の現行版は1.63です。ドキュメントには、Playwrightを更新するたびにエージェントの定義を再生成すべきだと書かれています。2026年9月14日確認。
エージェントが強いのは、道筋がわからない場面です。新機能の探索、あいまいなバグ報告の再現、フローの最初のバージョンの作成などです。一方、毎回同じ手順、同じデータ、同じ判定がほしいリグレッションには向いていません。実行時エージェントをレビューしたTestGuildは、エージェントによる実行はスクリプトより遅く、予測しにくい場合があると指摘しています。実用的な設計は、作成時とトリアージ時にモデルを一度だけ使い、承認された実行をコードとして保存し、そのコードをモデルなしで再生することです。コスト、速度、再現性が同時に良くなります。
AIが失敗するところと、人が持ち続けるもの
失敗のパターンはどのチームでも同じで、どれもプロンプトを改善しても直りません。
ビジネスの文脈がない。 モデルはコードと画面を読みます。一定額を超える返金には2人目の承認者が必要なことも、どの顧客層が遅い決済を許容できないかも知りません。生成するのはテストしやすそうなものであって、リスクの高いものではありません。
誤った自信。 生成されたテストや要約は、もっともらしく聞こえます。はっきり書かれた誤った根本原因は、原因がないよりも高くつきます。誰かを確信を持って間違った方向へ進ませるからです。
弱いアサーション。 最も生成しやすいテストは、画面を移動し、待ち、ページが読み込まれたことを確認するだけのものです。永遠に通り、何も検出しません。
プライバシーとデータの扱い。 本番のレコード、トークン、独自のソースコードを含むプロンプトは社外に出ます。ISTQBは、データのプライバシーとセキュリティをテストにおける生成AIの中心的なリスクとして挙げています。何を送ってよいかは、誰かが始める前に決めてください。後からではありません。
優先順位付けの偏り。 過去の失敗で学習した選択モデルは、以前壊れたところをテストし続けます。履歴のない新しいコードには注意が向きにくく、まさにそこにリグレッションが潜んでいます。
非決定性。 同じ依頼でも、日によって違う出力が返ることがあります。作成時には許容できても、合否を決めるゲートでは許容できません。だからモデルは再生のループの外に置くべきなのです。
通すために書き換えられたテスト。 スイートを緑にするよう頼まれたエージェントは、アサーションを弱めたり、待ち時間を延ばしたり、ケースを飛ばしたりすることがあります。レビューでアサーションを守り、不自然に早い修正には注意してください。
リリースの判断。 既知の不具合を抱えたまま出荷してよいかは、ユーザー、契約、タイミングについての判断です。それに必要な情報を持っているモデルはありません。
QtのAIテストに関する記事は、この協働関係をうまく表しています。「ソフトウェアテストの未来はAIか人間かではない。手動か自動かであったことが一度もないのと同じだ。」2026年9月14日確認。実際には、これは分業を意味します。AIは安価な機械的チェックを伴う量の作業を担います。人はリスク、あいまいさ、データの境界、出荷の判断を担います。
コントロールを失わずにQAにAIを導入する方法
成果を出すチームは、小さく始めて測定します。うまくいかないチームは、まずプラットフォームを買って期待することから始めます。
悩みを一つ選ぶ。 不安定なテストの保守、遅いパイプライン、薄いユニットカバレッジ、ノイズの多いトリアージ。今月時間を奪っているものを選んでください。ツールを選ぶ読者へのTestGuildの助言は「流行ではなく悩みから始める」で、これはツールが関わる前から当てはまります。2026年9月14日確認。
まずベースラインを測る。 現在の数値を書き留めます。テスト保守に使う週あたりの時間、パイプラインの所要時間(分)、失敗のうち本物の割合です。ベースラインがなければ、効果と作り話を区別できません。
代表的な作業で試験導入する。 サンプルアプリではなく、実際に変更が入る本物のリポジトリを使います。安定したUIしか見ないツールからは、保守について何もわかりません。
生の証拠を残す。 失敗したリクエスト、レスポンス、スクリーンショット、トレースです。モデルが書いた要約は調査の出発点であって、何が起きたかの記録にはなりません。
ゲートになる箇所ではレビューを必須にする。 マージを止められるものは、先に人が読みます。助言にとどまるものはそのまま流して構いません。
決定性の境界線を引く。 作成とトリアージにはモデル、実行には保存されたコード。次のツールに替えても残るよう、この境界を文書にしておきます。
そのうえで、うまくいっていれば動く指標を測ります。
採用されたテスト。 モデルが提案したテストのうち、レビューを通ってスイートに入った数。
有効な不具合。 AIを使った作業から見つかった本物のバグの数。ノイズとは分けて数えます。
保守時間。 テストの修正に使った週あたりの時間を、書き留めたベースラインと比べます。
不安定率。 コードの変更なしに失敗した実行の割合。エージェントによる実行は、これを押し上げる傾向があります。
流出した不具合。 本番に到達したバグ。選択によってスイートを削っているなら、削りすぎたときに教えてくれるのはこの数値です。
ベンダーの主張はこうした測定の外にあります。CloudBeesはSmart Testsについて、関連する失敗を捉えやすいテストを優先し、失敗を分類し、開発者へのフィードバックを最大80%速くすると述べています。2026年9月14日確認。これはベンダー自身の数値であり、ベンチマークではありません。判断の決め手になるのは、自社の試験導入の数値です。
AIコードテスト: AIが書いたコードのためのテスト
「AIコードテスト」には2つの意味があります。一つは、エディタで生成するユニットテストのように、AIを使って自分のコードのテストを書くことです。これには上の生成のセクションのフィルターが当てはまります。もう一つは、AIアシスタントが書いたコードをテストすることです。そのコードにも、他の誰が書いたコードとも同じ基準が必要です。レビュー、実際に動くテスト、そして動いているアプリでの確認です。モデルは、読みやすいのに間違った答えを返すコードを生み出すことがあるからです。レビューの側面は自動コードレビューのガイドで扱っています。
AIテストツールの費用
2026年11月11日に各ベンダー自身のページで確認した価格からは、4つの課金モデルが見えてきます。自社の月間実行回数で比較してください。
| ツール | AIがすること | 価格 |
|---|---|---|
| Qodex | エージェントが一文からAPI、UI、セキュリティのテストを書き、その後スクリプトとして再生する | Individual は $0 で25シナリオ、月100回の実行。Startup は1プロジェクトあたり月額 $1,299 から |
| QA Wolf | エージェントがPlaywrightとAppiumのテストを書いて修復する | 最大5分のWeb実行1回につき $1、シート料金なし |
| Momentic | AIによるテスト作成と自動修復 | 月 $50 分の利用までは無料。Scale は月 $500 |
| Autify | エージェントのAximoがWebとモバイルのアプリをテストする | Individual は $0 で一回限りの2,000クレジット。Core は年払いで月 $99 |
| mabl | AIの支援付きローコードテスト | 公開価格なし。14日間のトライアル |
他のツールが向いている場面: QodexがテストするのはWebアプリとAPIで、ネイティブのモバイルアプリではありません。モバイル中心のチームにはAutify、Momentic、QA Wolfが向いています。出典: QA Wolf、Momentic、Autify、mabl、Qodex。
自分のアプリでAIテストを試してみませんか?Qodexを無料で始めて、フローを一つ説明してください。
よくある質問
ソフトウェアテストにおけるAIとは何ですか?
テスト作業を支えるためにAIを使うことです。シナリオの下書き、テストコードの作成、データの作成、アプリの操作、壊れた自動化の修復、ビジュアルの比較、変更に対するテストの順位付け、失敗のグループ化などです。ISTQBのCT-GenAIシラバスがこの領域を扱っています。AIを組み込んだ製品をテストすることとは別で、そちらはCT-AI v2.0が扱っています。
QAテスターは今日AIをどう使っていますか?
主に、安価なチェックを伴う量の作業に使っています。テスターは要件からテストケースの下書きを作り、ユニットテストやエンドツーエンドテストを生成し、合成データを作ります。UIが変わったときにはロケーターの修復を提案させ、大量のCIの失敗を短い一覧に要約させます。何がリスクかを決め、モデルが出したものをレビューし、リリースの判断に責任を持つのはテスターです。
AIテストとテスト自動化の違いは何ですか?
自動化は設計上決定的です。同じビルド、同じデータ、同じ環境であれば、スクリプトは同じ手順を実行して同じ判定を出し、それを人が保守します。3つのどれかが変われば結果も変わりうるため、これらの入力を管理することが重要です。AIは別の意味で確率的です。提案し、順位付けし、修復し、説明しますが、同じ入力でも実行ごとに出力が変わることがあります。うまく機能する構成では、AIは実行経路の中ではなく自動化の周りに置かれるため、ゲートは入力と同じだけ再現性を保てます。AIによるテスト自動化が実際にどう機能するか、そしてどの指標とROIで評価すべきかは、AIテスト自動化のガイドをご覧ください。
AIは信頼できるテストケースを生成できますか?
フィルターにかける必要のある、役に立つ候補を生成します。MetaのTestGen-LLMの評価では、生成されたケースの75%がビルドでき、57%が安定して通り、25%がカバレッジを高めました。自社の出力にも同じフィルターを適用してください。コンパイルできる、繰り返し通る、カバレッジを上げる、本当に何かを検証している、そしてマージを止められるようになる前に、その機能を知る人が承認する、の5つです。
自己修復テストとは何ですか?
UIが変わったときに、自分で修復案を出すテストです。モデルが属性、テキスト、視覚的な文脈を読み、古い手順がどの要素を指していたかを推定し、新しいロケーターや手順を提案します。mablとApplitoolsはどちらもこの機能を提供しています。安全に保つためのルールは、自己修復で変えてよいのはテストが要素を見つける方法だけで、テストが検証する内容は決して変えないことです。
AIは探索的テストを実行できますか?
部分的にはできます。エージェントは新機能を歩き回り、スクリプトなら試さない入力を試し、誰も書き留めていなかった状態を見つけ出せます。これは未知の領域では本当に役立ちます。しかし、このビジネスに何が損害を与えるかという仮説は立てられませんし、技術的には正しくてもユーザーにとっては間違っていることにも気づきません。エージェントの実行は、テスターの代わりではなく、テスターのための素材として扱ってください。
AIはQAテスターに取って代わりますか?
いいえ。そして、なくなる仕事は重要な仕事ではありません。定型的なケースの下書き、ロケーターの修正、ログの読み込みは減ります。何がリスクかを決めること、あいまいな振る舞いを読み解くこと、不具合を出荷してよいかを議論すること、本当にバグを捉えるアサーションを設計することは減りません。モデルの出力を指示し監査できるテスターは、結果として面白いほうの半分をより多く担うことになります。
ソフトウェアテストにおけるAIのリスクは何ですか?
何も検証せずに通るテスト。間違った要素に一致して、緑のビルドを嘘にしてしまう修復。自信たっぷりだが誤った失敗の説明。プロンプトに送られる本番データやソースコード。すでに壊れたところをテストし続け、新しいコードを無視する優先順位付け。実行ごとに変わる出力。対策はリスクごとに異なります。弱いアサーション、誤った修復、ぶれる出力は、機械的なゲートで捉えられます。アサーションのレビュー、カバレッジの増分、壊れたビルドで失敗しなければならないテスト、順位付けされた一部のテストの背後でスケジュール実行するフルスイートです。プライバシー、偏り、リリースの判断はそうはいきません。何を送ってよいかについての文書化されたルール、順位付けによってテストされなくなったものを見張る人、そして出荷の判断に責任を持つ人が必要です。
AIテストはツールですか、サービスですか、それとも能力ですか?
これらのどの形でも購入できる能力です。プラットフォームは製品の中の機能として販売します。代理店はAI支援型のテストサービスとして販売します。オープンソースは、Playwrightのプランナー、ジェネレーター、ヒーラーのエージェントのように、それを直接提供します。実際に買っているのは、ワークフローのどこにモデルを置くか、そしてその出力を誰がレビューするかです。3つのどれも、その観点で評価してください。
AIテストで広く認められた「30%ルール」はありますか?
ありません。この言葉は検索候補に出てきますが、30%ルールを定義しているテスト標準、シラバス、信頼できる団体はなく、それに結び付けられる数字も引用する人によってばらばらです。無視してください。AIがテスト作業のどれだけに関わるかは、自社のスイートで、採用されたテスト、有効な不具合、保守時間、流出した不具合を測定して決めてください。