IA em testes de software: o que ela faz hoje
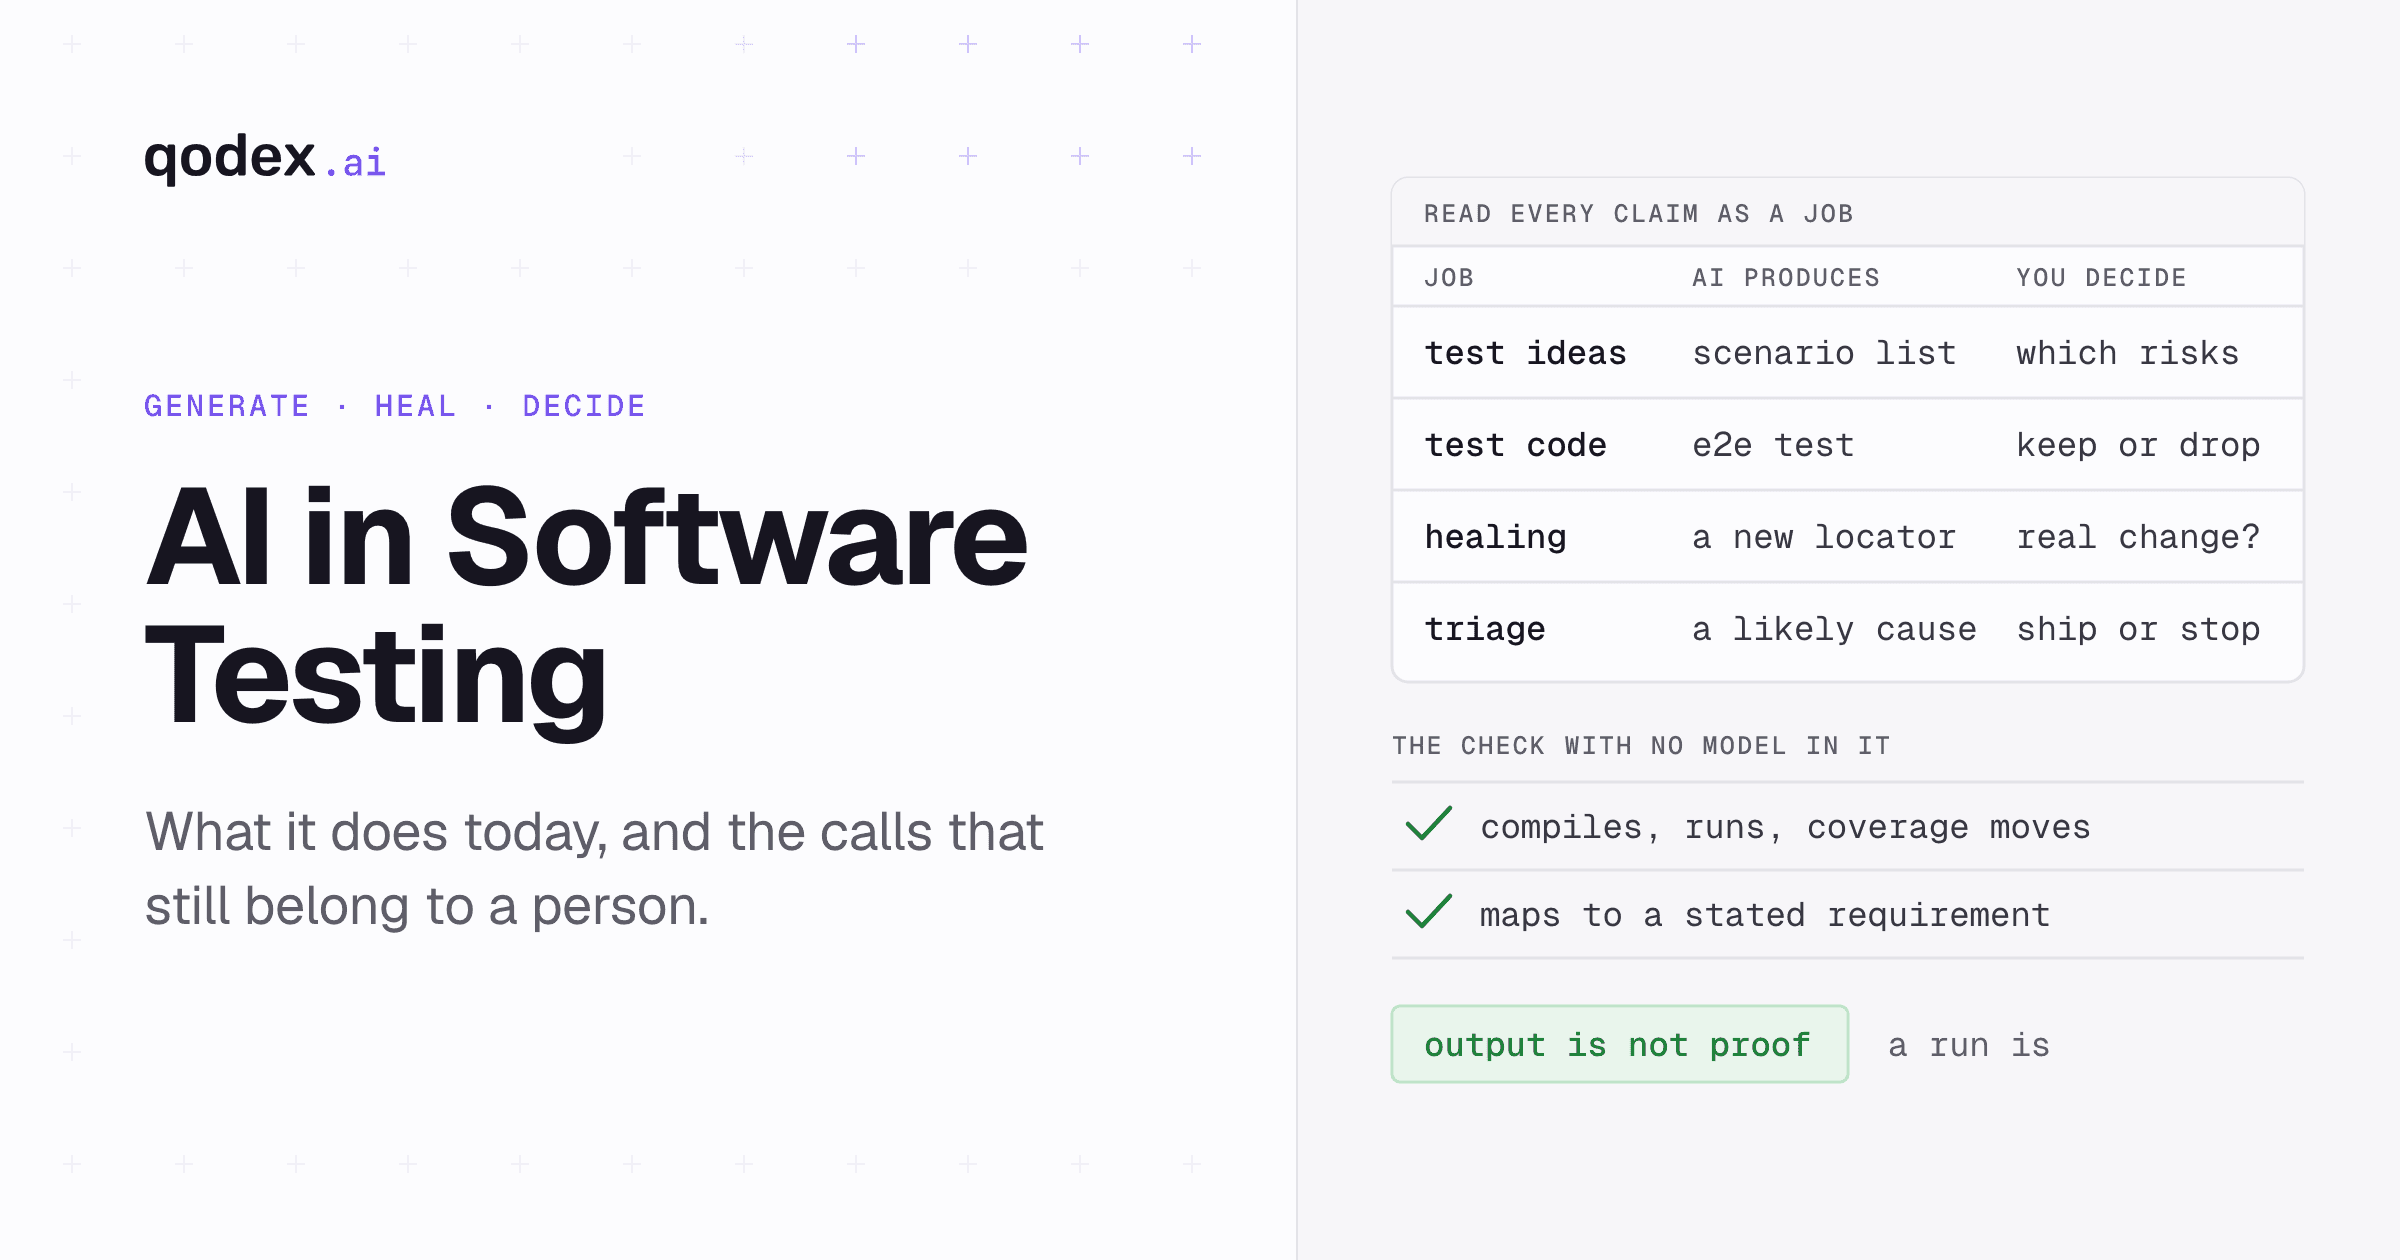
A IA em testes de software ajuda as equipes a desenhar casos de teste, gerar dados e scripts, escolher quais testes rodar, adaptar a automação quando a interface muda, comparar resultados visuais e investigar falhas. Ela funciona melhor como assistente em volta de verificações determinísticas, não como juiz de se o software está bom o bastante. As pessoas continuam definindo o risco, interpretando comportamentos ambíguos, protegendo dados sensíveis e decidindo se as evidências sustentam um lançamento.
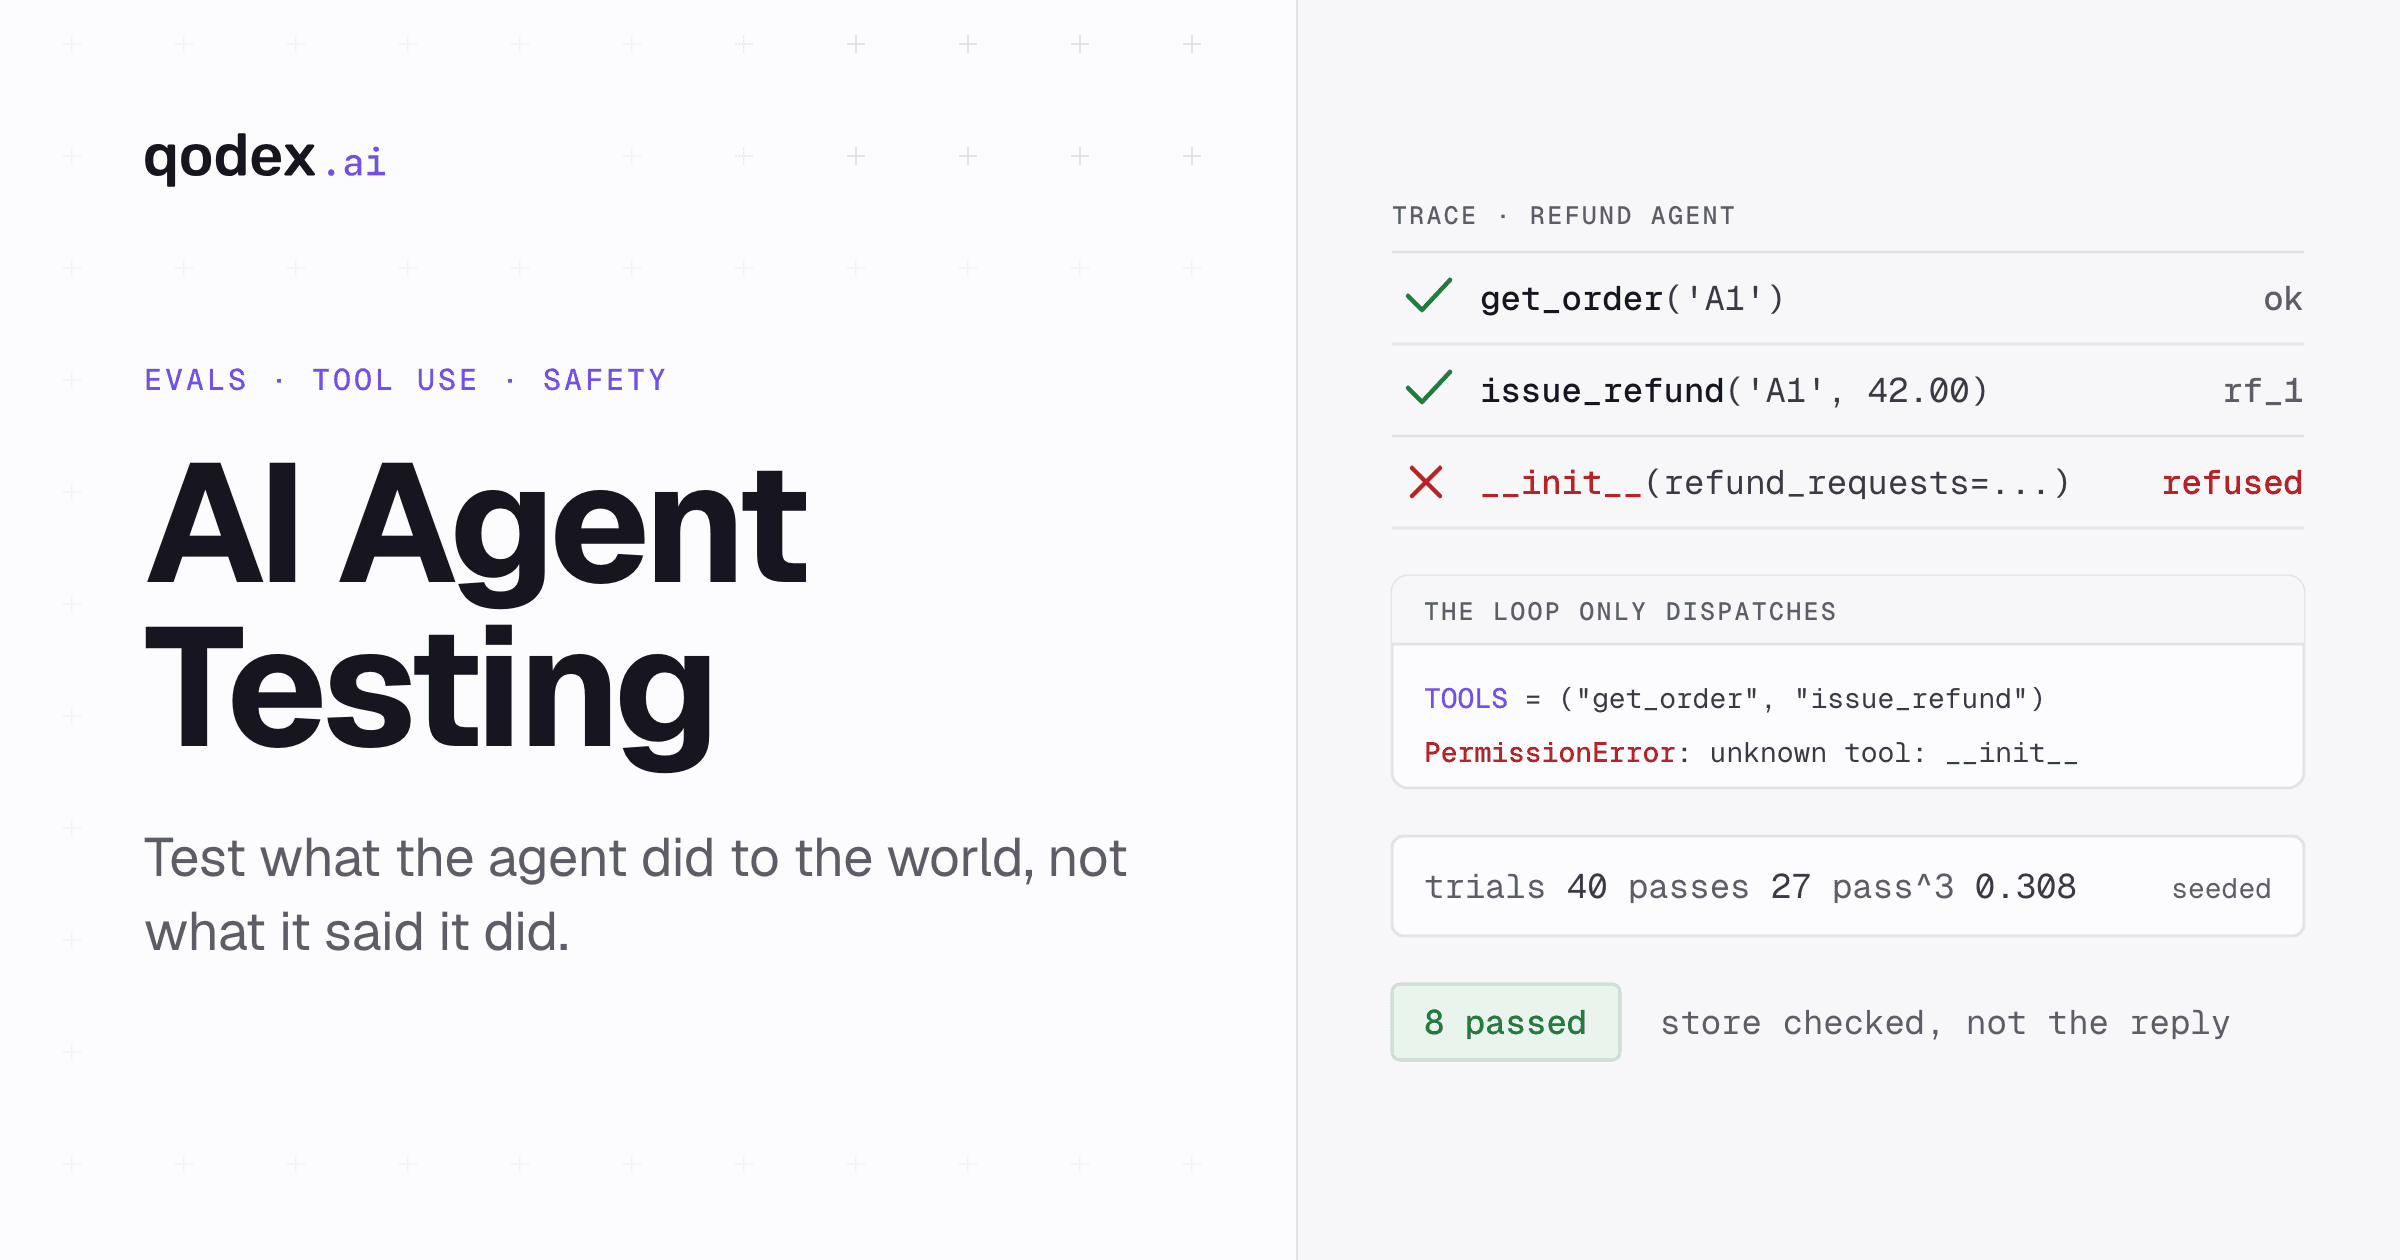
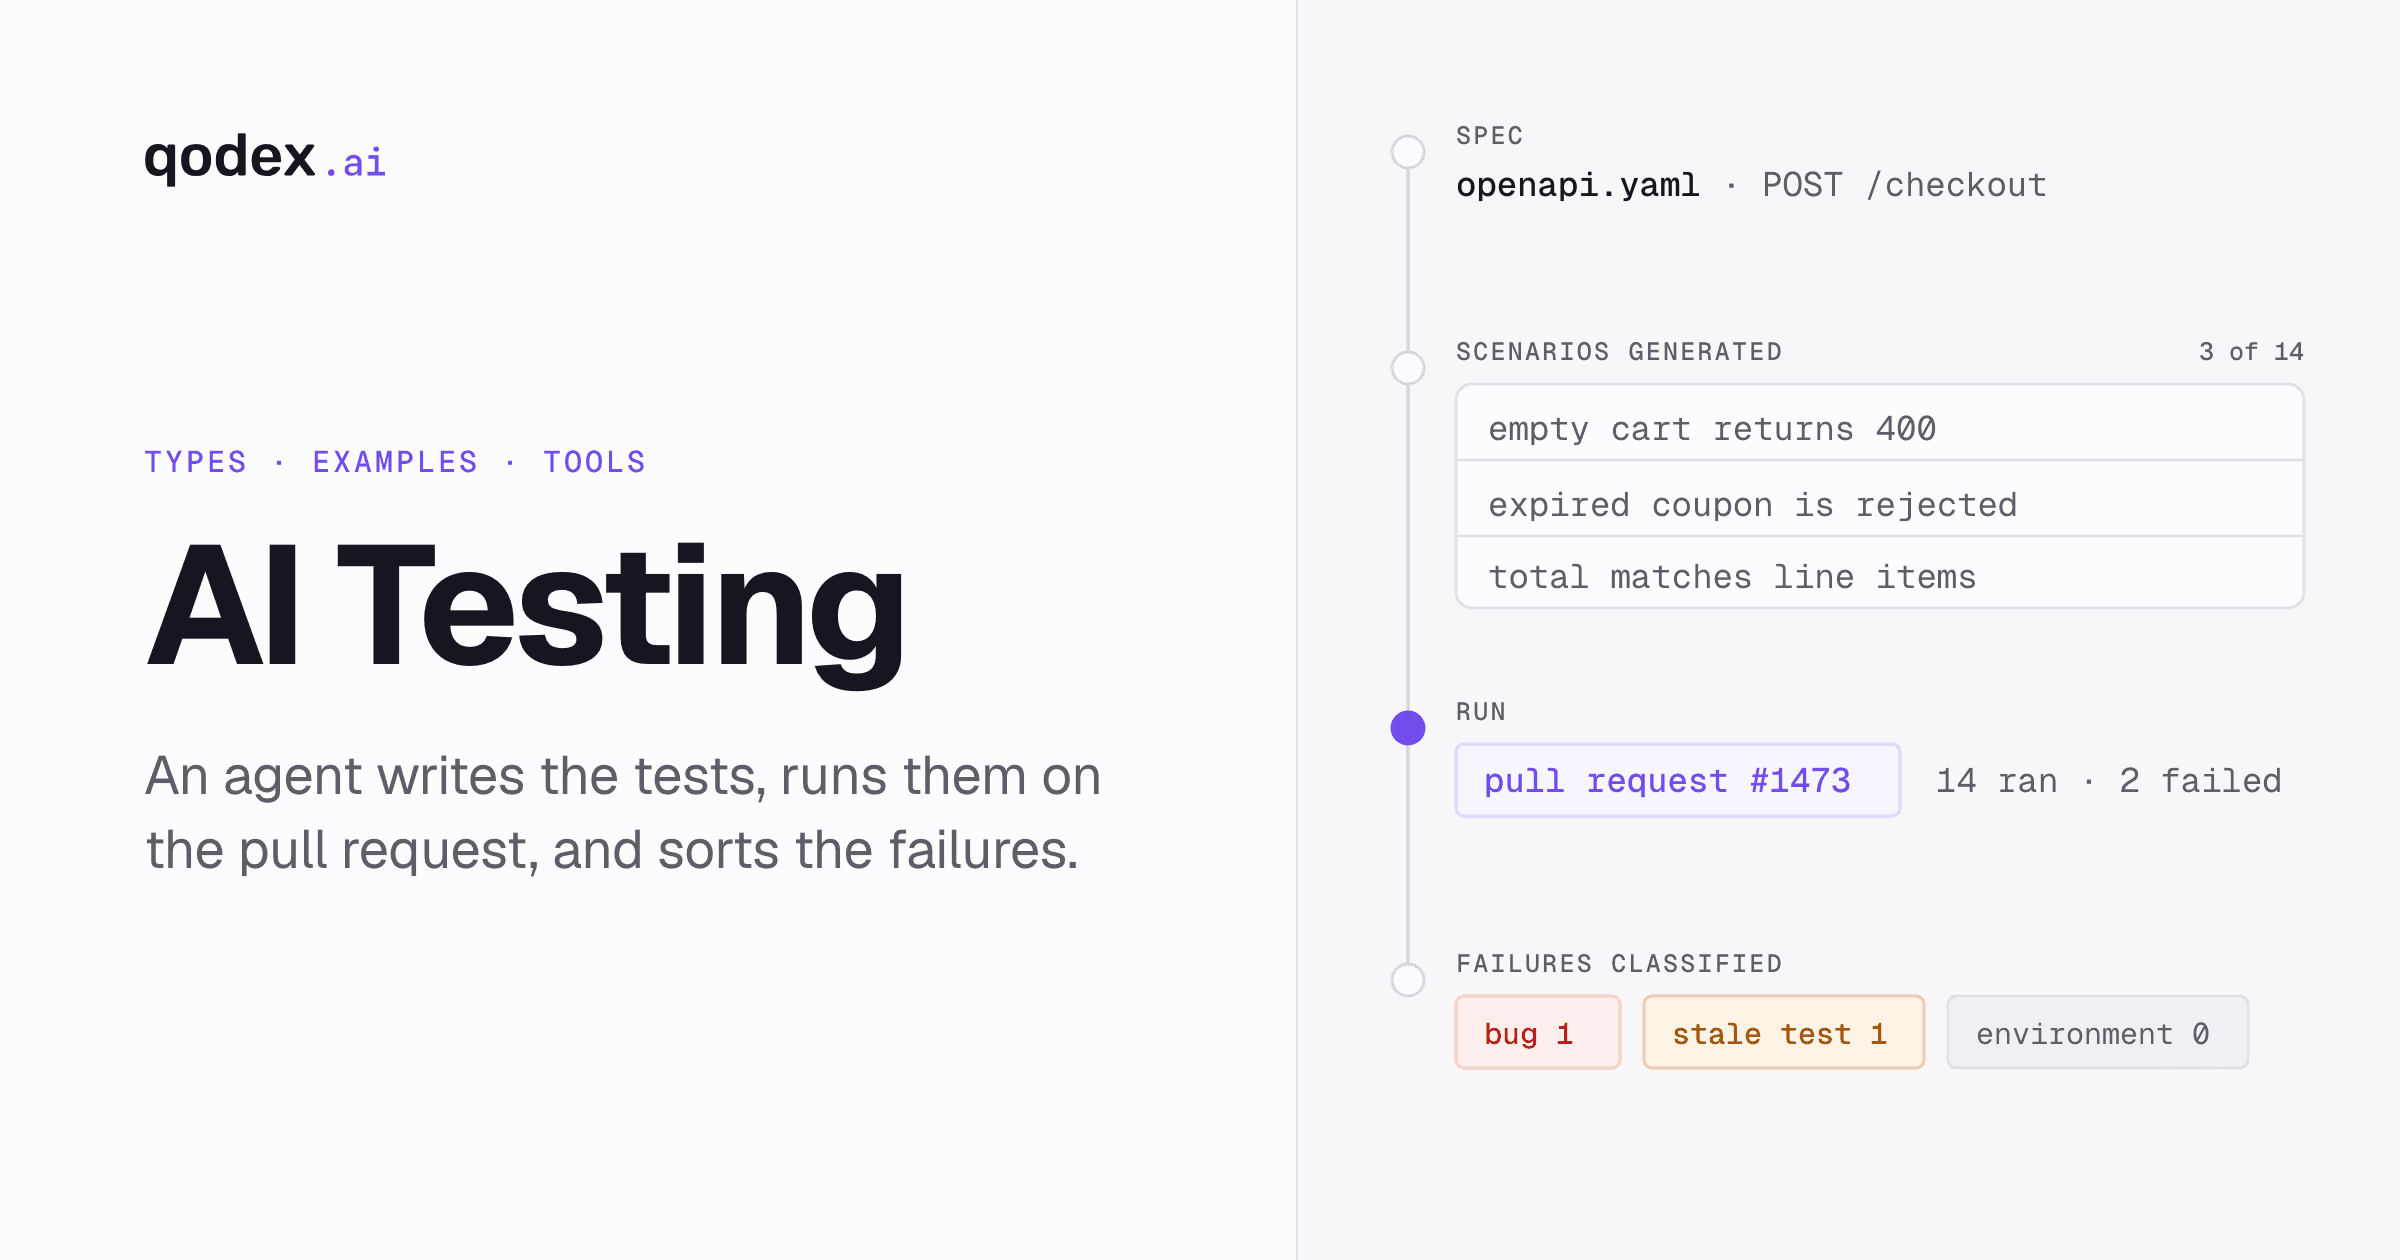
Descreva o fluxo em uma frase. O Qodex conduz a aplicação real, traz uma captura de tela do que quebrou e salva a execução como código Playwright que é seu.
Esta página explica o que a tecnologia realmente faz hoje. Se você está escolhendo um produto, a lista das melhores ferramentas de QA com IA faz a comparação, incluindo plataformas sem código como o mabl e seus vizinhos próximos. O guia de QA com IA cobre as técnicas de aprendizado de máquina, linguagem e visão por trás disso, e testes de regressão com IA mostra o que tudo isso significa dentro de uma suíte de regressão. Esta página fica no nível das tarefas: o que a IA faz, o que a verifica e o que uma pessoa ainda decide.
Como escolher onde usar IA nos testes
| Pergunta | Por que importa | Como é uma boa resposta |
|---|---|---|
| Qual dor custa mais a você neste mês? | A IA ajuda mais em um gargalo específico | Escolha um: escrever testes, manutenção instável, pipelines lentos ou triagem barulhenta |
| O resultado é código que você mantém? | Um teste preso ao formato de um fornecedor é difícil de revisar ou migrar | Scripts legíveis em um framework padrão, guardados no git |
| Cada reexecução chama um modelo? | Chamadas ao modelo em cada execução fazem custo e resultados variarem | O modelo escreve o teste uma vez; as reexecuções repetem um script fixo |
| Quem aprova o que a IA escreveu? | Testes gerados podem passar sem verificar nada | Testes novos começam como rascunho até uma pessoa promovê-los |
| Que dados ela vê? | Dados de homologação e credenciais saem da sua rede | SOC 2 ou ISO 27001, controles de retenção de dados, sua própria chave de modelo se precisar |
O que significa IA em testes de software
Duas tarefas diferentes têm o mesmo nome. Uma é usar IA para fazer trabalho de teste. A outra é testar um produto que tem IA dentro. O ISTQB separa as duas, e essa divisão ajuda a ler qualquer página de fornecedor.
Usar IA para testar. O programa CT-GenAI trata de testadores que aplicam IA generativa à análise de requisitos, ao design de testes, à automação e aos relatórios, e cita como riscos a gerenciar as alucinações, os erros de raciocínio, o viés, a privacidade e segurança dos dados e o consumo de energia. Consultado em 14 de setembro de 2026.
Testar sistemas de IA. O programa CT-AI v2.0 trata de testar sistemas baseados em IA, incluindo sistemas de aprendizado de máquina e grandes modelos de linguagem, com testes de dados de entrada, testes de modelo e testes do desenvolvimento de ML. Ele lida com o comportamento probabilístico, o não determinismo, os dados, os modelos e as características de qualidade do sistema sob teste, um conjunto de problemas diferente do desta página. Consultado em 14 de setembro de 2026.
Esta página trata da primeira tarefa. Dentro dela, quatro tecnologias diferentes são chamadas de IA, e se comportam de formas diferentes.
Assistência generativa. Um modelo de linguagem rascunha planos, casos, scripts, dados e resumos. O resultado é probabilístico, então o mesmo prompt pode devolver outra coisa amanhã.
Classificação e priorização. Um modelo ordena testes em relação a uma mudança, agrupa falhas parecidas e sinaliza padrões que parecem instáveis.
Visão computacional. Páginas renderizadas são comparadas em busca de diferenças de layout e renderização, em vez de verificar atributos do DOM um por um.
Agentes em tempo de execução. Um modelo conduz a aplicação, decide o próximo passo e reage ao que vê, em vez de repetir um script fixo.
Pergunte qual das quatro uma funcionalidade usa. A resposta prevê o quanto ela é repetível, como você a valida e quanto custa rodá-la.
O que a IA faz ao longo do ciclo de testes
O jeito útil de ler qualquer afirmação sobre testes com IA é como uma tarefa com uma entrada, um resultado, uma verificação que não usa nenhum modelo e uma decisão que fica com uma pessoa. A tabela abaixo faz isso para o trabalho que a IA toca hoje.
| Tarefa de teste | Entrada de que a IA precisa | Resultado que a IA produz | Verificação determinística | Decisão humana | Melhor uso | Risco principal |
|---|---|---|---|---|---|---|
| Transformar requisitos em ideias de teste | Requisito, fluxo do usuário, acesso à aplicação | Lista de cenários com casos de borda | Cada cenário corresponde a um requisito declarado | Quais riscos importam nesta versão | Funcionalidades novas ou mal documentadas | Cenários plausíveis que erram o risco real |
| Rascunhar um plano de teste | Escopo, ambiente, um teste inicial | Plano legível com passos e dados | O plano roda uma vez à mão de ponta a ponta | Cobertura e profundidade por área | Planejamento de regressão para uma aplicação conhecida | Cobertura que parece completa, mas não é |
| Gerar testes executáveis | Código-fonte, plano, exemplos | Código de testes unitários ou ponta a ponta | Compilar, rodar, variação de cobertura, revisão das asserções | Se o teste deve entrar na suíte | Testes unitários e fluxos do caminho feliz | Testes que passam sem verificar nada |
| Montar dados de teste | Esquema, restrições, volume | Registros sintéticos e fixtures | Validação de esquema e restrições | Quais dados de produção podem sair da empresa | Dados de carga e registros de casos de borda | Dados reais vazando para um prompt |
| Conduzir a aplicação em execução | Acesso à aplicação, objetivo em palavras | Uma execução concluída ou com falha | Captura de tela, log de rede, código de saída | Se um desvio é um bug | Exploração e primeira versão de um teste | Mais lento e menos repetível que um script |
| Consertar automação quebrada | Teste com falha, estado da página, histórico | Mudança proposta de localizador ou passo | O teste falha no build antigo e passa no novo | Aceitar, rejeitar ou investigar | Mudanças cosméticas e estruturais da interface | Um reparo que aponta em silêncio para o elemento errado |
| Comparar o resultado visual | Linha de base e renderização atual | Regiões com diferença e um veredito | Linha de base aprovada por uma pessoa | Se a diferença é intencional | Regressões de layout e entre navegadores | Ruído filtrado até que quebras reais passem |
| Selecionar testes para uma mudança | Diff, histórico, dados de cobertura | Subconjunto ordenado para rodar agora | Suíte completa agendada como rede de segurança | Se o subconjunto basta para o merge | Suítes grandes e pipelines lentos | Regressão perdida fora do conjunto ordenado |
| Triar e resumir falhas | Logs, traces, capturas, histórico | Falhas agrupadas e uma causa provável | O artefato bruto da falha continua sendo a evidência | A causa raiz real e a correção | CI barulhenta com falhas repetidas | Um resumo confiante que está errado |
O planejamento vem antes de tudo isso, e a mecânica dele está no guia de criação de plano de teste. No lado das APIs, a geração é o uso mais maduro, desenvolvido em automatizar testes de API com IA em 30 minutos e no guia de testes de API mais amplo. Seleção e triagem compensam dentro do pipeline, que é onde testes de regressão com IA e as tendências atuais de CI/CD retomam o assunto.
Geração de testes: resultado útil não é prova
A geração é a única área com evidência independente publicada, e essa evidência é específica, não geral.
A Meta rodou seu sistema TestGen-LLM nos Reels e Stories do Instagram. Dos casos de teste produzidos, 75% compilaram corretamente, 57% passaram de forma confiável e 25% aumentaram a cobertura. São resultados de avaliação de uma única implantação, não uma taxa de sucesso que você deva esperar no seu próprio código. Consultado em 14 de setembro de 2026.
O CoverUp, um gerador de testes para Python que devolve as lacunas de cobertura ao prompt, alcançou uma mediana de cobertura de linhas e ramos por módulo de 80%, contra 47% do CodaMosa, e de 89% no total, contra 77% do MuTAP. De novo, são números de benchmark em módulos de código aberto. Consultado em 14 de setembro de 2026.
Leia os dois resultados do mesmo jeito. Um modelo consegue escrever muito código de teste rapidamente, e uma parte relevante dele é errada, fraca ou redundante. Tudo bem, porque os filtros são baratos e mecânicos.
Compila. Tudo o que não compila é descartado sem que uma pessoa olhe.
Roda e passa repetidamente. Rode cada candidato várias vezes. Descarte tudo o que oscilar.
Aumenta a cobertura. Mantenha o candidato só se ele cobrir linhas ou ramos que faltavam à suíte.
Verifica algo. Um teste que executa código sem verificar o resultado é um sinal falso. Desenhar asserções é uma habilidade à parte, tratada no guia de asserções do Playwright.
Uma pessoa aprova. Alguém que conhece a funcionalidade lê o teste antes que ele possa bloquear um merge.
A geração também começa antes do código. O agente planejador do Playwright explora uma aplicação em execução e escreve um plano em Markdown que você pode ler antes de qualquer coisa ser gerada a partir dele, e precisa de um pedido claro e de um teste inicial para trabalhar. Isso dá a uma pessoa um ponto de revisão antes que a geração de testes comece. Fonte: Playwright Test Agents, consultado em 14 de setembro de 2026.
As ferramentas embutem cada vez mais esses filtros. O GitHub documenta a geração de testes unitários como um fluxo do Copilot, e o agente gerador do Playwright verifica seletores e asserções ao vivo contra a aplicação em execução enquanto escreve o teste. Ambos consultados em 14 de setembro de 2026. Nenhum dos dois elimina a etapa de revisão.
Autocorreção e execução por agentes
Duas capacidades são confundidas porque ambas usam um modelo em tempo de execução.
Construir uma funcionalidade de IA cria um segundo problema de QA: testar o agente de IA em suas ferramentas, decisões de várias etapas, barreiras de proteção e execuções repetidas.
A autocorreção conserta automação que quebrou porque a interface mudou. Quando um botão muda seus atributos, um modelo usa os atributos ao redor, o texto visível e o contexto visual para propor um localizador ou passo substituto. O mabl descreve um agente que atualiza testes de forma autônoma e pergunta a uma pessoa o motivo de uma ação quando precisa desse contexto. A afirmação de eliminar até 95% da manutenção de testes é um número do próprio fornecedor, publicado sem método. A Applitools diz que seus localizadores encontram um elemento alterado por pistas visuais e semânticas, e que sua Visual AI detecta regressões de renderização e layout. Também é uma afirmação do fornecedor. Ambos consultados em 14 de setembro de 2026.
O enquadramento honesto é que a autocorreção muda como um teste encontra as coisas, e nunca pode mudar o que o teste verifica. Um localizador consertado que aponta para um elemento parecido, mas diferente, transforma um build verde em uma mentira. Trate cada reparo como um pull request: ele é proposto, revisado e reversível, e o teste precisa falhar no build quebrado antes que o reparo conte. A mecânica de cada fornecedor, incluindo o que cada um expõe para revisão e reversão, está em testes de regressão com IA.
A execução por agentes é diferente. Aqui o modelo conduz a aplicação rumo a um objetivo e decide cada próximo passo. O Playwright traz agentes planejador, gerador e reparador, adicionados na versão 1.56, com a 1.63 como atual nas notas de versão. A documentação observa que as definições dos agentes devem ser regeneradas sempre que o Playwright for atualizado. Consultado em 14 de setembro de 2026.
Agentes são fortes onde o caminho é desconhecido: explorar uma funcionalidade nova, reproduzir um relato de bug vago ou escrever a primeira versão de um fluxo. Eles se encaixam mal na regressão, em que você quer os mesmos passos, os mesmos dados e o mesmo veredito em toda execução. O TestGuild, ao analisar agentes em tempo de execução, aponta que a execução por agentes pode ser mais lenta e menos previsível do que um script. O desenho prático é usar o modelo uma vez, na escrita e na triagem, depois salvar a execução aprovada como código e repetir esse código sem modelo no ciclo. Custo, velocidade e repetibilidade melhoram ao mesmo tempo.
Onde a IA falha e o que continua com as pessoas
As falhas são as mesmas entre equipes, e nenhuma delas se resolve com um prompt melhor.
Falta de contexto de negócio. Um modelo lê o código e a tela. Ele não sabe que um reembolso acima de certo valor precisa de um segundo aprovador, nem qual segmento de clientes não tolera um checkout lento. Ele gera o que parece testável, não o que é arriscado.
Falsa confiança. Testes e resumos gerados soam autoritativos. Uma causa raiz errada dita com clareza custa mais do que nenhuma, porque manda alguém pelo caminho errado com convicção.
Asserções fracas. O teste mais fácil de gerar navega, espera e verifica que a página carregou. Ele passa para sempre e não pega nada.
Privacidade e tratamento de dados. Prompts que levam registros de produção, tokens ou código proprietário saem da sua empresa. O ISTQB lista a privacidade e a segurança dos dados como um risco central da IA generativa em testes. Decida o que pode ser enviado antes de alguém começar, não depois.
Viés na priorização. Um modelo de seleção treinado em falhas passadas continua testando o que já quebrou antes. Código novo sem histórico recebe menos atenção, e é exatamente aí que as regressões se escondem.
Não determinismo. O mesmo pedido pode produzir resultados diferentes em dias diferentes. Isso é aceitável na escrita e inaceitável em um portão de aprovação, e por isso o modelo deve ficar fora do ciclo de repetição.
Testes reescritos para passar. Um agente a quem se pede para deixar a suíte verde pode enfraquecer uma asserção, alongar uma espera ou pular um caso. Proteja a asserção na revisão e desconfie de correções suspeitamente rápidas.
A decisão de lançamento. Se um defeito conhecido pode ir para produção é um julgamento sobre usuários, contratos e prazos. Nenhum modelo tem a informação necessária para fazê-lo.
O texto da Qt sobre IA em testes descreve bem a relação de trabalho: "O futuro dos testes de software não é IA ou humano, assim como nunca foi manual ou automatizado." Consultado em 14 de setembro de 2026. A versão prática disso é uma divisão de trabalho. A IA faz o trabalho de volume com uma verificação mecânica barata junto. As pessoas cuidam do risco, da ambiguidade, dos limites dos dados e da decisão de lançar.
Como adotar IA em QA sem perder o controle
Equipes que tiram valor disso começam pequeno e medem. As que não tiram começam comprando uma plataforma e torcendo.
Escolha uma dor. Manutenção instável, pipelines lentos, pouca cobertura unitária ou triagem barulhenta. Escolha a que está custando tempo neste mês. O conselho do TestGuild a quem escolhe uma ferramenta é "começar pela dor, não pelo hype", e ele vale antes de qualquer ferramenta entrar em jogo. Consultado em 14 de setembro de 2026.
Meça a linha de base primeiro. Anote o número atual: horas por semana em manutenção de testes, minutos de duração do pipeline, porcentagem de falhas que são reais. Sem linha de base, você não distingue um benefício de uma história.
Faça o piloto com trabalho representativo. Use um repositório real com mudanças reais, não uma aplicação de exemplo. Uma ferramenta que só vê uma interface estável não diz nada sobre manutenção.
Guarde a evidência bruta. A requisição que falhou, a resposta, a captura de tela, o trace. Um resumo escrito pelo modelo é um ponto de partida para a investigação e nunca o registro do que aconteceu.
Exija revisão onde bloqueia. Tudo o que pode bloquear um merge é lido antes por uma pessoa. O que é só consultivo pode seguir.
Trace a linha do determinismo. Modelo na escrita e na triagem. Código salvo na execução. Escreva essa fronteira para que ela sobreviva à próxima ferramenta.
Depois, meça o que se move se isso estiver funcionando.
Testes aceitos. Dos testes que o modelo propôs, quantos passaram pela revisão e entraram na suíte.
Defeitos válidos. Quantos bugs reais vieram do trabalho assistido por IA, separados do ruído.
Tempo de manutenção. Horas por semana gastas consertando testes, comparadas à linha de base que você anotou.
Taxa de instabilidade. Fração das execuções que falham sem mudança de código. A execução por agentes tende a aumentá-la.
Defeitos escapados. Bugs que chegaram à produção. Se a seleção está enxugando a suíte, esse é o número que diz quando ela cortou demais.
As afirmações dos fornecedores ficam fora de tudo isso. A CloudBees diz que o Smart Tests prioriza testes com maior chance de pegar falhas relevantes, classifica falhas e entrega retorno aos desenvolvedores até 80% mais rápido. Consultado em 14 de setembro de 2026. É o número do próprio fornecedor, não um benchmark. Os números do seu piloto são os que decidem.
Teste de código com IA: testes para código que uma IA escreveu
"Teste de código com IA" significa duas coisas. Uma é usar IA para escrever testes para o seu código, como testes unitários gerados no editor; os filtros da seção de geração acima se aplicam. A outra é testar código que um assistente de IA escreveu. Esse código precisa do mesmo padrão que o de qualquer pessoa: revisão, testes que rodam e uma verificação na aplicação em execução, porque um modelo pode produzir código que parece bom e devolve a resposta errada. Nosso guia de revisão de código automatizada cobre o lado da revisão.
Quanto custam as ferramentas de teste com IA
Os preços, consultados na própria página de cada fornecedor em 11 de novembro de 2026, mostram quatro modelos de cobrança. Compare-os com o seu próprio número de execuções por mês.
| Ferramenta | O que a IA faz | Preço |
|---|---|---|
| Qodex | Um agente escreve testes de API, de interface e de segurança a partir de uma frase e depois os repete como scripts | Individual US$ 0 com 25 cenários e 100 execuções por mês; Startup a partir de US$ 1.299 por projeto por mês |
| QA Wolf | Agentes escrevem testes em Playwright e Appium e os consertam | US$ 1 por execução web de até 5 minutos, sem taxa por assento |
| Momentic | Escrita de testes com IA e autocorreção | Grátis com US$ 50 de uso por mês; Scale US$ 500 por mês |
| Autify | O agente Aximo testa aplicações web e mobile | Individual US$ 0 com 2.000 créditos únicos; Core US$ 99 por mês com cobrança anual |
| mabl | Testes low-code com assistência de IA | Sem preço público; teste grátis de 14 dias |
Onde outras se encaixam melhor: o Qodex testa aplicações web e APIs, não aplicativos móveis nativos, então Autify, Momentic ou QA Wolf servem melhor a uma equipe focada em mobile. Fontes: QA Wolf, Momentic, Autify, mabl e Qodex.
Quer ver testes com IA na sua própria aplicação? Comece grátis com o Qodex e descreva um fluxo.
Perguntas frequentes
O que é IA em testes de software?
Usar IA para apoiar o trabalho de teste: rascunhar cenários, escrever código de teste, montar dados, conduzir a aplicação, consertar automação quebrada, comparar resultados visuais, ordenar testes em relação a uma mudança e agrupar falhas. O programa CT-GenAI do ISTQB cobre esse terreno. É algo separado de testar um produto que tem IA dentro, que é o que o CT-AI v2.0 cobre.
Como os testadores de QA usam IA hoje?
Principalmente para trabalho de volume com uma verificação barata junto. Os testadores a usam para rascunhar casos de teste a partir de um requisito, gerar testes unitários e ponta a ponta e criar dados sintéticos. Ela também propõe reparos de localizadores quando a interface muda e resume um paredão de falhas de CI em uma lista curta. O testador decide o que é arriscado, revisa o que o modelo produziu e é dono da decisão de lançamento.
Qual é a diferença entre teste com IA e automação de testes?
A automação é determinística por definição. Com o mesmo build, os mesmos dados e o mesmo ambiente, um script executa os mesmos passos e dá o mesmo veredito, e uma pessoa o mantém. Mude qualquer um dos três e o resultado pode mudar, e por isso controlar essas entradas importa. A IA é probabilística de outra forma: ela propõe, ordena, conserta e explica, e o resultado pode variar entre execuções com entradas idênticas. Em uma configuração que funciona, a IA fica em volta da automação, não dentro do caminho de execução, então o portão de aprovação continua tão repetível quanto as suas entradas. Para ver como a automação de testes com IA funciona na prática, e as métricas e o ROI pelos quais medi-la, leia nosso guia de automação de testes com IA.
A IA consegue gerar casos de teste confiáveis?
Ela gera candidatos úteis que precisam de filtro. Na avaliação do TestGen-LLM da Meta, 75% dos casos gerados compilaram, 57% passaram de forma confiável e 25% aumentaram a cobertura. Aplique os mesmos filtros aos seus resultados: compila, passa repetidamente, aumenta a cobertura, verifica algo real, e uma pessoa que conhece a funcionalidade o aprova antes que ele possa bloquear um merge.
O que são testes com autocorreção?
Testes que propõem o próprio reparo quando a interface muda. Um modelo lê atributos, texto e contexto visual, descobre a que elemento o passo antigo se referia e sugere um novo localizador ou passo. O mabl e a Applitools oferecem uma versão disso. A regra que mantém isso seguro é que a autocorreção pode mudar como um teste encontra um elemento, nunca o que o teste verifica.
A IA consegue fazer testes exploratórios?
Em parte. Um agente pode percorrer uma funcionalidade nova, tentar entradas que um script não tentaria e revelar estados que ninguém anotou, o que é de fato útil em terreno desconhecido. Ele não consegue formular uma hipótese sobre o que prejudicaria este negócio, e não percebe que algo está tecnicamente correto, mas errado para o usuário. Trate execuções de agentes como matéria-prima para um testador, não como substituto.
A IA vai substituir os testadores de QA?
Não, e o trabalho que desaparece não é o que importa. Rascunhar casos repetitivos, consertar localizadores e ler logs diminui. Decidir o que é arriscado, interpretar comportamentos ambíguos, discutir se um defeito pode ir para produção e desenhar a asserção que de fato pega o bug não diminui. Testadores que sabem dirigir e auditar o que o modelo produz acabam fazendo mais da metade interessante.
Quais são os riscos da IA em testes de software?
Testes que passam sem verificar nada. Reparos que apontam para o elemento errado e transformam um build verde em mentira. Explicações de falhas confiantes, mas erradas. Dados de produção e código-fonte enviados em um prompt. Uma priorização que continua testando o que já quebrou e ignora o código novo. Resultados que variam entre execuções. Os controles variam conforme o risco. Asserções fracas, reparos ruins e resultados que oscilam são pegos por filtros mecânicos: revisão de asserções, uma variação de cobertura, um teste que precisa falhar no build quebrado e uma suíte completa agendada por trás de qualquer subconjunto ordenado. Privacidade, viés e a decisão de lançamento, não. Esses exigem uma regra escrita sobre o que pode ser enviado, uma pessoa observando o que a ordenação deixa de testar e um responsável humano pela decisão de lançar.
Teste com IA é uma ferramenta, um serviço ou uma capacidade?
Uma capacidade que você pode comprar de qualquer uma das formas. Plataformas a vendem como funcionalidades dentro de um produto. Agências a vendem como um serviço de testes assistido por IA. O código aberto a entrega diretamente, como nos agentes planejador, gerador e reparador do Playwright. O que você está comprando de verdade é o lugar do modelo no seu fluxo de trabalho e quem revisa o que ele produz, então julgue qualquer uma das três por isso.
Existe uma regra reconhecida dos 30% para IA em testes?
Não. A expressão aparece nas sugestões de busca, mas nenhum padrão de testes, programa ou órgão confiável define uma regra dos 30%, e os números associados a ela mudam conforme quem a cita. Ignore-a. Decida quanto do seu trabalho de teste a IA toca medindo testes aceitos, defeitos válidos, horas de manutenção e defeitos escapados na sua própria suíte.