L'IA dans les tests logiciels : ce qu'elle fait aujourd'hui
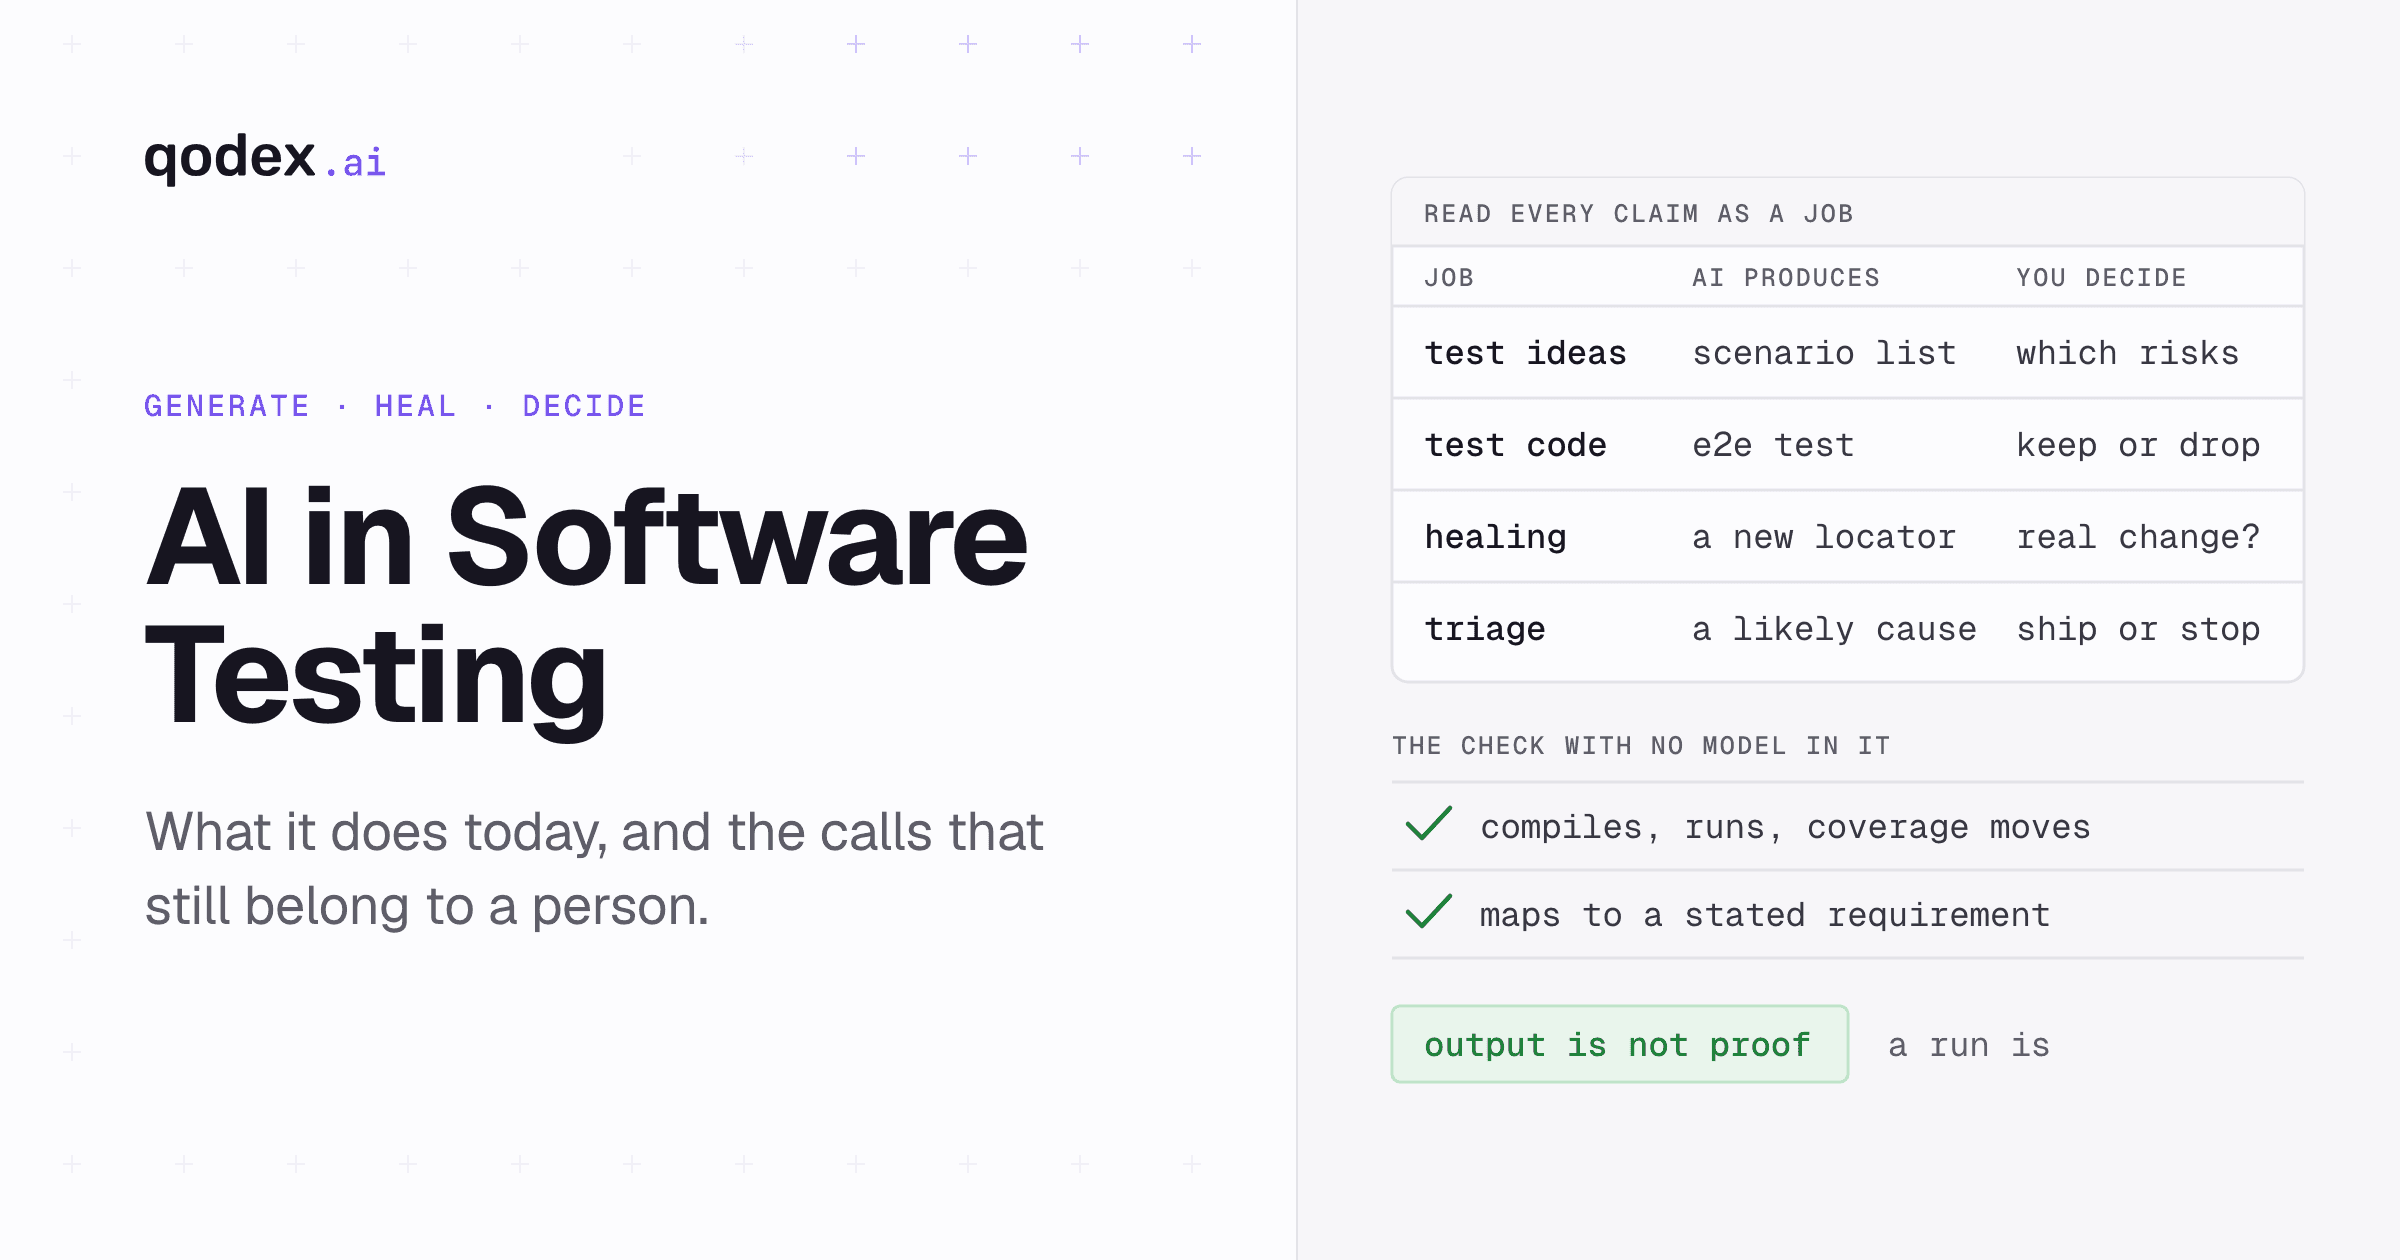
L'IA dans les tests logiciels aide les équipes à concevoir des cas de test, générer des données et des scripts, choisir quels tests exécuter, adapter l'automatisation quand l'interface bouge, comparer des résultats visuels et analyser les échecs. Elle fonctionne au mieux comme un assistant placé autour de contrôles déterministes, pas comme un juge qui décide si le logiciel est assez bon. Les humains continuent de fixer le risque, d'interpréter les comportements ambigus, de protéger les données sensibles et de décider si les preuves justifient une mise en production.
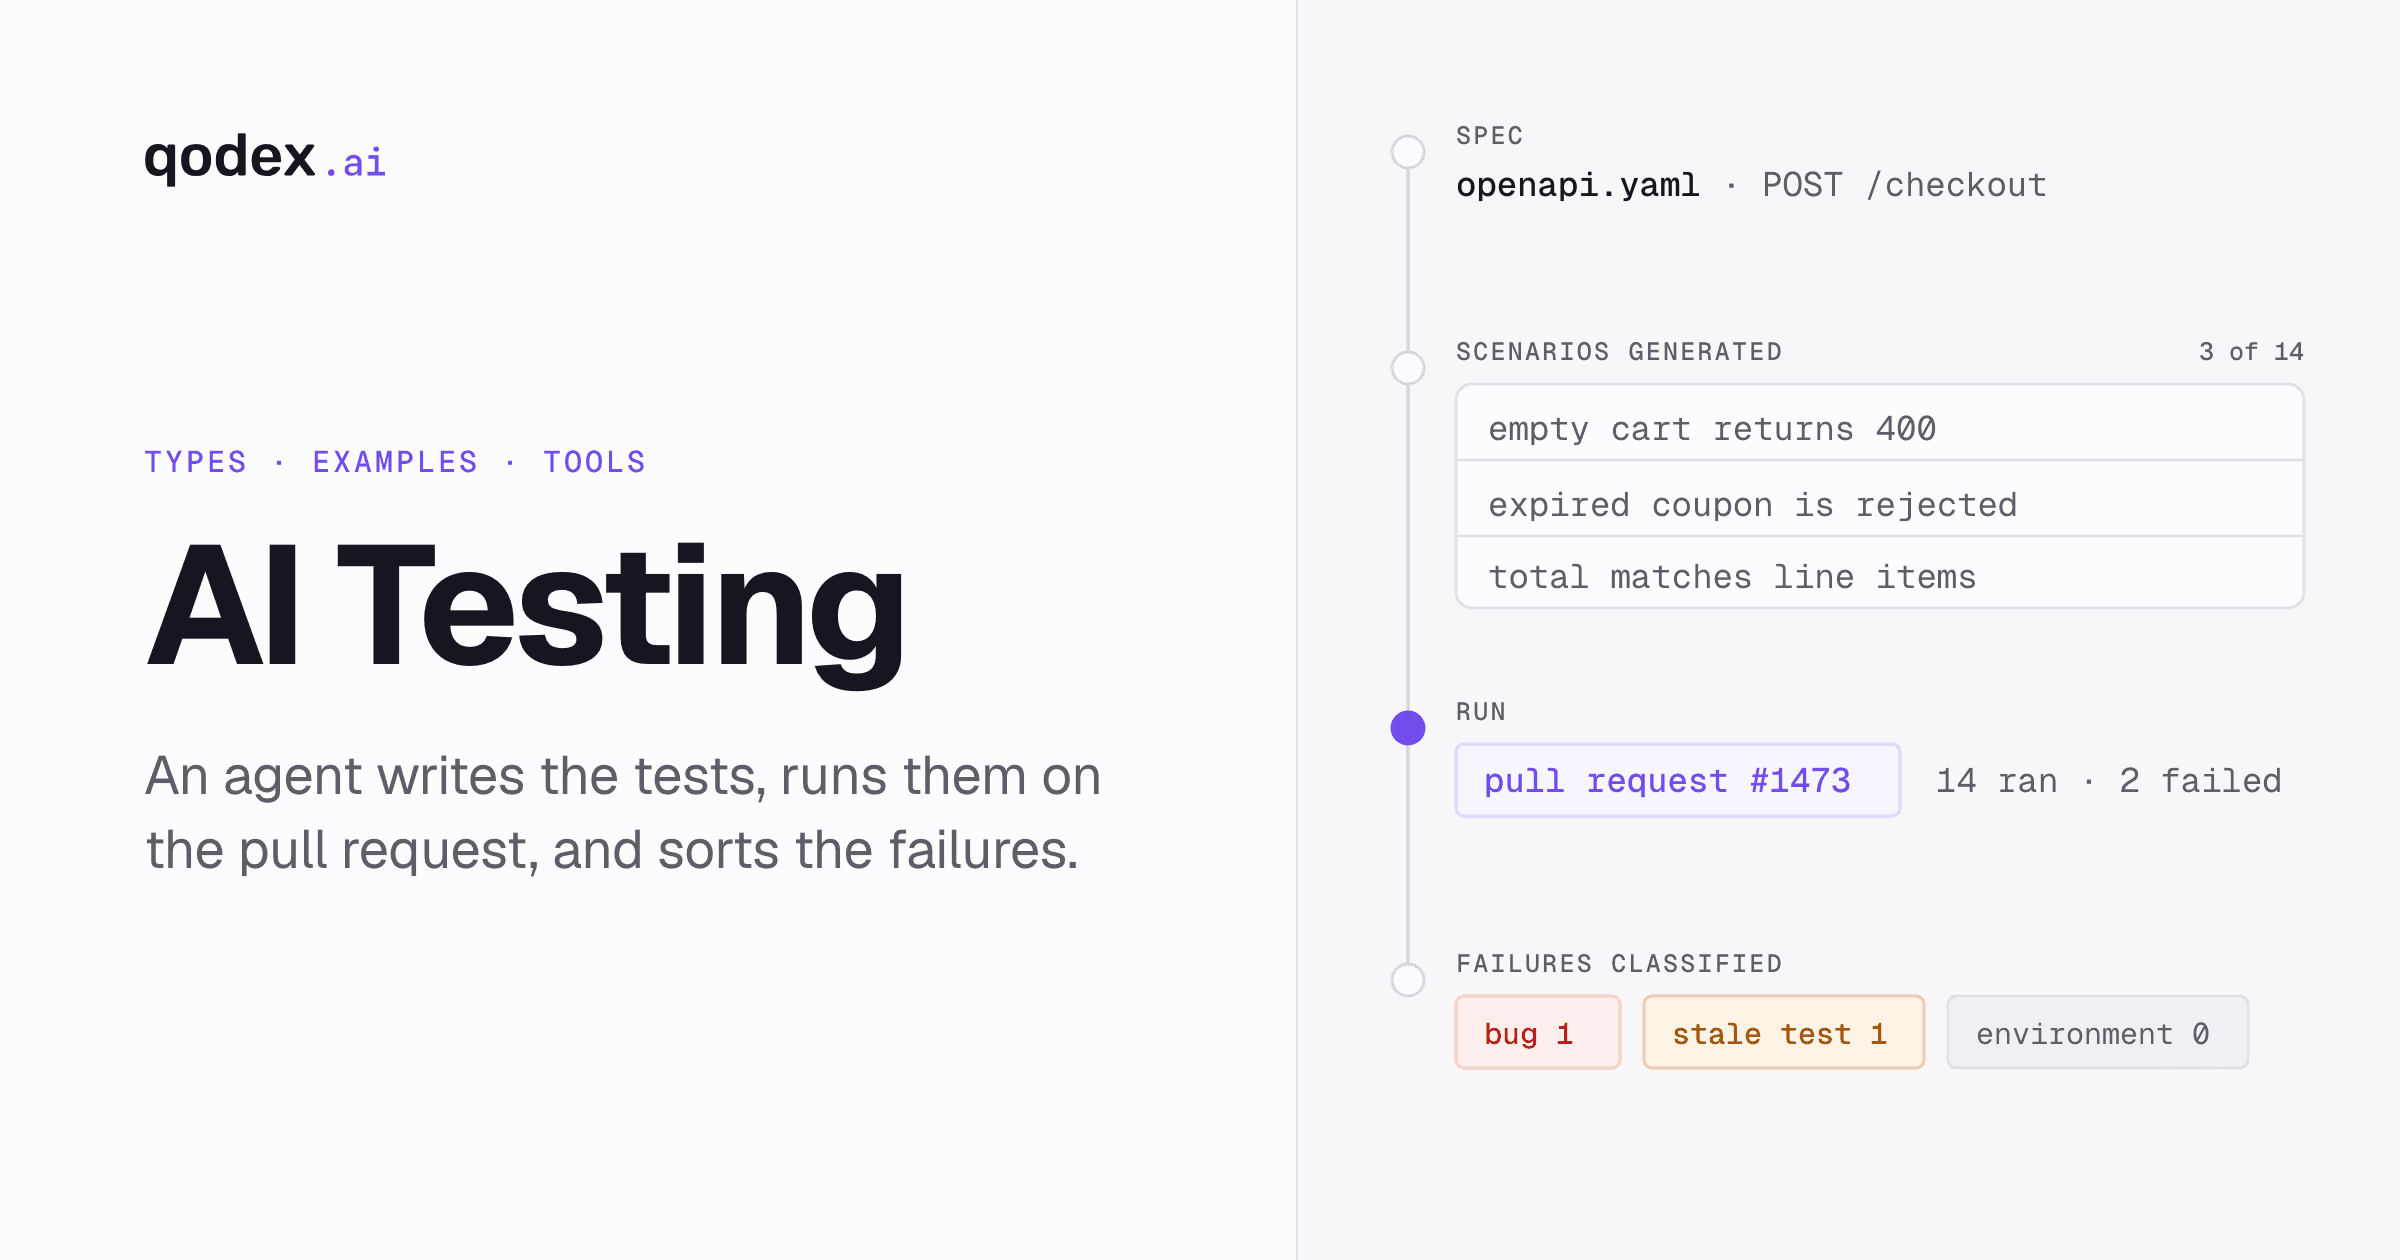
Décrivez le parcours en une phrase. Qodex pilote la vraie application, rapporte une capture de ce qui a cassé et enregistre l'exécution sous forme de code Playwright qui vous appartient.
Cette page explique ce que la technologie fait réellement aujourd'hui. Si vous cherchez un outil, la sélection des meilleurs outils de QA à base d'IA compare les produits, y compris les plateformes sans code comme mabl et ses proches voisins. Le guide de la QA par l'IA couvre les techniques d'apprentissage automatique, de langage et de vision sous-jacentes, et les tests de régression par l'IA expliquent ce que tout cela signifie dans une suite de régression. Cette page reste au niveau des tâches : ce que fait l'IA, ce qui la contrôle et ce qu'une personne décide encore.
Comment choisir où utiliser l'IA dans les tests
| Question | Pourquoi c'est important | À quoi ressemble une bonne réponse |
|---|---|---|
| Quel problème vous coûte le plus ce mois-ci ? | L'IA aide surtout sur un goulot d'étranglement précis | Choisissez-en un : écrire les tests, maintenance instable, pipelines lents ou tri bruyant |
| Le résultat est-il du code que vous gardez ? | Un test enfermé dans le format d'un éditeur est difficile à relire ou à migrer | Des scripts lisibles dans un framework standard, conservés dans git |
| Chaque relance appelle-t-elle un modèle ? | Des appels au modèle à chaque exécution font varier le coût et les résultats | Le modèle écrit le test une fois ; les relances rejouent un script fixe |
| Qui valide ce que l'IA a écrit ? | Des tests générés peuvent passer sans rien vérifier | Les nouveaux tests commencent comme brouillons jusqu'à ce qu'une personne les valide |
| Quelles données voit-elle ? | Les données de préproduction et les identifiants sortent de votre réseau | SOC 2 ou ISO 27001, contrôle de la conservation des données, votre propre clé de modèle si besoin |
Ce que signifie l'IA dans les tests logiciels
Deux tâches différentes portent le même nom. L'une consiste à utiliser l'IA pour faire du travail de test. L'autre consiste à tester un produit qui contient de l'IA. L'ISTQB les sépare, et cette distinction aide à lire n'importe quelle page d'éditeur.
Utiliser l'IA pour tester. Le programme CT-GenAI couvre les testeurs qui appliquent l'IA générative à l'analyse des exigences, la conception des tests, l'automatisation et le reporting, et cite comme risques à gérer les hallucinations, les erreurs de raisonnement, les biais, la confidentialité et la sécurité des données, et la consommation d'énergie. Consulté le 14 septembre 2026.
Tester des systèmes d'IA. Le programme CT-AI v2.0 couvre le test des systèmes à base d'IA, dont les systèmes d'apprentissage automatique et les grands modèles de langage, avec des tests des données d'entrée, des tests de modèles et des tests du développement ML. Il traite du comportement probabiliste, du non-déterminisme, des données, des modèles et des caractéristiques de qualité du système testé, un ensemble de problèmes différent de celui de cette page. Consulté le 14 septembre 2026.
Cette page porte sur la première tâche. À l'intérieur, quatre technologies différentes sont appelées IA, et elles se comportent différemment.
Assistance générative. Un modèle de langage rédige des plans, des cas, des scripts, des données et des résumés. Le résultat est probabiliste : le même prompt peut renvoyer autre chose demain.
Classification et priorisation. Un modèle classe les tests par rapport à un changement, regroupe les échecs similaires et signale les motifs qui semblent instables.
Vision par ordinateur. Les pages rendues sont comparées pour repérer des différences de mise en page et de rendu, au lieu de vérifier les attributs du DOM un par un.
Agents à l'exécution. Un modèle pilote l'application, décide de l'étape suivante et réagit à ce qu'il voit au lieu de rejouer un script fixe.
Demandez laquelle des quatre une fonctionnalité utilise. La réponse prédit à quel point elle est reproductible, comment vous la validez et ce qu'elle coûte à exécuter.
Ce que fait l'IA tout au long du cycle de test
La bonne façon de lire toute affirmation sur les tests par l'IA est de la voir comme une tâche avec une entrée, un résultat, un contrôle qui n'utilise aucun modèle et une décision qui reste à une personne. Le tableau ci-dessous le fait pour le travail que l'IA touche aujourd'hui.
| Tâche de test | Entrée dont l'IA a besoin | Résultat produit par l'IA | Contrôle déterministe | Décision humaine | Meilleur usage | Risque principal |
|---|---|---|---|---|---|---|
| Transformer des exigences en idées de test | Exigence, parcours utilisateur, accès à l'application | Liste de scénarios avec cas limites | Chaque scénario correspond à une exigence énoncée | Quels risques comptent pour cette version | Fonctionnalités nouvelles ou mal documentées | Des scénarios plausibles qui ratent le vrai risque |
| Rédiger un plan de test | Périmètre, environnement, un test de départ | Plan lisible avec étapes et données | Le plan s'exécute une fois à la main de bout en bout | Couverture et profondeur par domaine | Planification de régression pour une application connue | Une couverture qui semble complète mais ne l'est pas |
| Générer des tests exécutables | Code source, plan, exemples | Code de tests unitaires ou de bout en bout | Compiler, exécuter, écart de couverture, relecture des assertions | Si le test a sa place dans la suite | Tests unitaires et parcours nominaux | Des tests qui passent sans rien vérifier |
| Construire des données de test | Schéma, contraintes, volume | Enregistrements synthétiques et fixtures | Validation du schéma et des contraintes | Quelles données de production peuvent sortir | Données de charge et enregistrements de cas limites | Des données réelles qui fuient dans un prompt |
| Piloter l'application à l'exécution | Accès à l'application, objectif en mots | Une exécution réussie ou en échec | Capture d'écran, journal réseau, code de sortie | Si un écart est un bug | Exploration et première version d'un test | Plus lent et moins reproductible qu'un script |
| Réparer une automatisation cassée | Test en échec, état de la page, historique | Modification proposée du localisateur ou de l'étape | Le test échoue sur l'ancien build et passe sur le nouveau | Accepter, refuser ou enquêter | Changements cosmétiques et structurels de l'interface | Une réparation qui cible en silence le mauvais élément |
| Comparer le rendu visuel | Référence et rendu actuel | Zones de différence et un verdict | Référence validée par une personne | Si la différence est voulue | Régressions de mise en page et entre navigateurs | Un bruit filtré jusqu'à laisser passer de vraies casses |
| Sélectionner les tests pour un changement | Diff, historique, données de couverture | Sous-ensemble classé à exécuter maintenant | La suite complète planifiée en filet de sécurité | Si le sous-ensemble suffit pour fusionner | Grandes suites et pipelines lents | Une régression ratée hors de l'ensemble classé |
| Trier et résumer les échecs | Logs, traces, captures, historique | Échecs regroupés et une cause supposée | L'artefact brut de l'échec reste la preuve | La vraie cause racine et la correction | CI bruyante avec échecs répétés | Un résumé assuré qui se trompe |
La planification se situe en amont de tout cela, et sa mécanique est traitée dans le guide de création d'un plan de test. Côté API, la génération est l'usage le plus mûr, détaillé dans automatiser les tests d'API avec l'IA en 30 minutes et dans le guide des tests d'API plus large. La sélection et le tri sont rentables dans le pipeline, là où les tests de régression par l'IA et les tendances CI/CD actuelles reprennent le fil.
Génération de tests : un résultat utile n'est pas une preuve
La génération est le seul domaine où il existe des preuves indépendantes publiées, et ces preuves sont précises, pas générales.
Meta a appliqué son système TestGen-LLM aux Reels et aux Stories d'Instagram. Parmi les cas de test produits, 75 % se sont compilés correctement, 57 % sont passés de manière fiable et 25 % ont augmenté la couverture. Ce sont des résultats d'évaluation issus d'un seul déploiement, pas un taux de réussite à attendre sur votre propre code. Consulté le 14 septembre 2026.
CoverUp, un générateur de tests Python qui renvoie les manques de couverture dans le prompt, a atteint une couverture médiane des lignes et des branches par module de 80 % contre 47 % pour CodaMosa, et de 89 % au total contre 77 % pour MuTAP. Là encore, ce sont des chiffres de benchmark sur des modules open source. Consulté le 14 septembre 2026.
Lisez les deux résultats de la même façon. Un modèle peut écrire beaucoup de code de test rapidement, et une part notable est fausse, faible ou redondante. Ce n'est pas grave, car les filtres sont bon marché et mécaniques.
Il compile. Tout ce qui ne se construit pas est écarté sans qu'une personne le regarde.
Il s'exécute et passe de façon répétée. Exécutez chaque candidat plusieurs fois. Écartez tout ce qui clignote.
Il ajoute de la couverture. Ne gardez le candidat que s'il couvre des lignes ou des branches qui manquaient à la suite.
Il vérifie quelque chose. Un test qui exécute du code sans vérifier le résultat est un faux signal. Concevoir des assertions est une compétence à part, traitée dans le guide des assertions Playwright.
Une personne le valide. Quelqu'un qui connaît la fonctionnalité lit le test avant qu'il puisse bloquer une fusion.
La génération commence aussi avant le code. L'agent planificateur de Playwright explore une application en cours d'exécution et écrit un plan en Markdown que vous pouvez lire avant que quoi que ce soit en soit généré ; il lui faut une demande claire et un test de départ. Cela donne à une personne un point de relecture avant que la génération des tests commence. Source : Playwright Test Agents, consulté le 14 septembre 2026.
Les outils intègrent de plus en plus ces filtres. GitHub documente la génération de tests unitaires comme un flux Copilot, et l'agent générateur de Playwright vérifie en direct les sélecteurs et les assertions contre l'application en cours d'exécution pendant qu'il écrit le test. Tous deux consultés le 14 septembre 2026. Aucun ne supprime l'étape de relecture.
Auto-réparation et exécution par agents
Deux capacités sont confondues parce que toutes deux font intervenir un modèle à l'exécution.
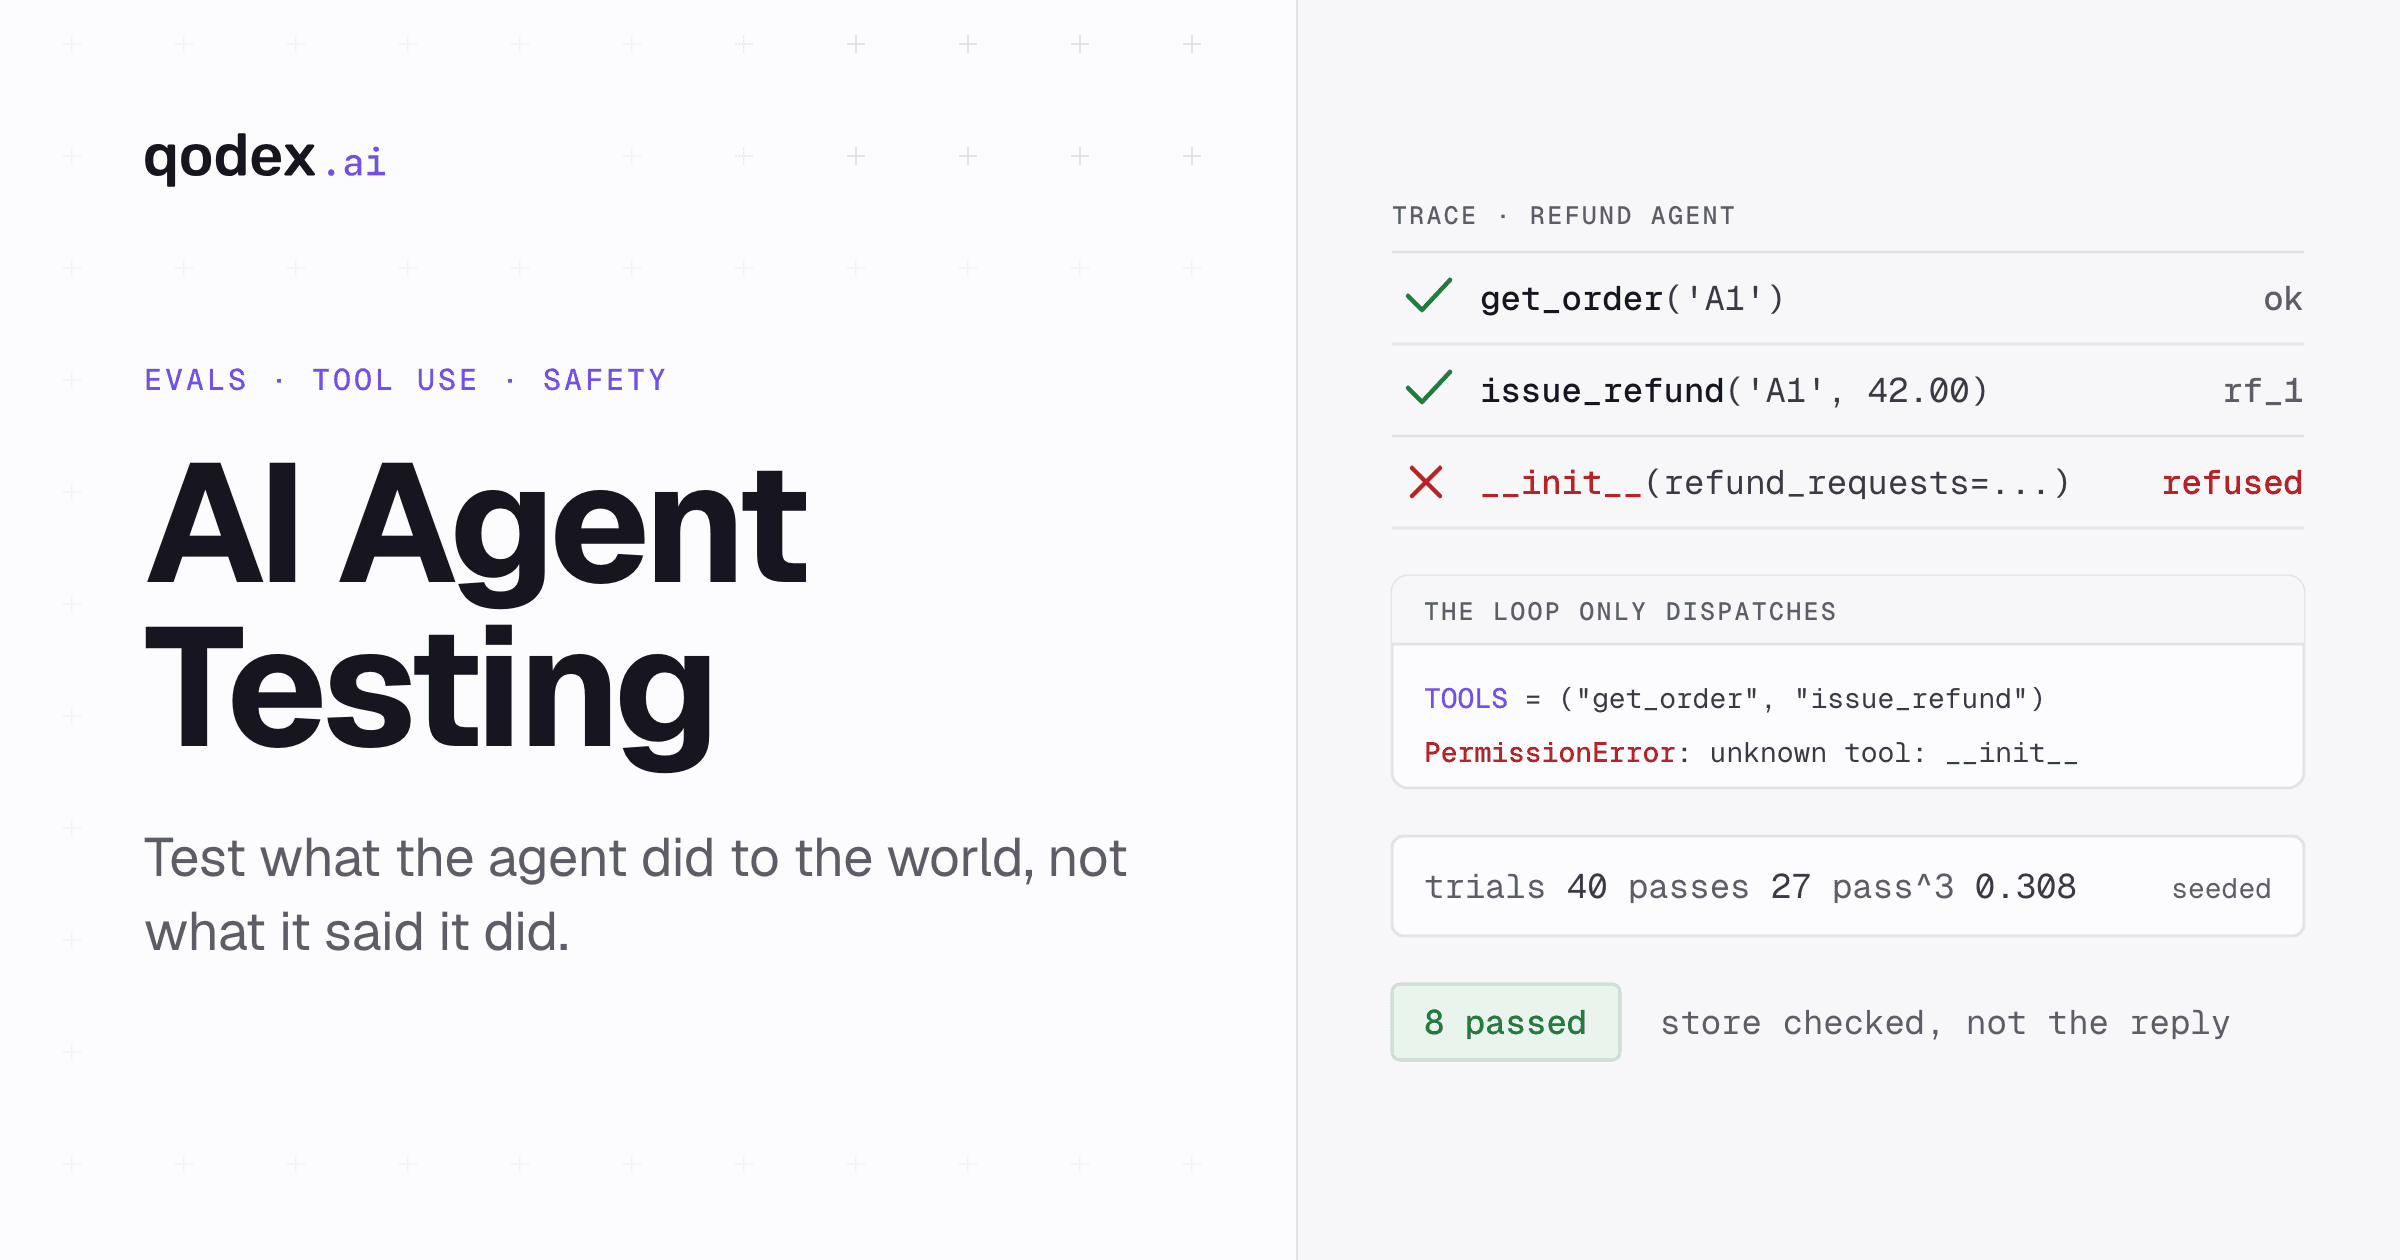
Construire une fonctionnalité d'IA crée un second problème de QA : tester l'agent d'IA à travers ses outils, ses décisions en plusieurs étapes, ses garde-fous et ses exécutions répétées.
L'auto-réparation répare une automatisation cassée parce que l'interface a bougé. Quand un bouton change d'attributs, un modèle utilise les attributs voisins, le texte visible et le contexte visuel pour proposer un localisateur ou une étape de remplacement. mabl décrit un agent qui met à jour les tests de manière autonome et demande à une personne la raison d'une action quand il a besoin de ce contexte. Son affirmation d'éliminer jusqu'à 95 % de la maintenance des tests est un chiffre de l'éditeur lui-même, publié sans méthode. Applitools affirme que ses localisateurs retrouvent un élément modifié grâce à des indices visuels et sémantiques, et que son Visual AI détecte les régressions de rendu et de mise en page. C'est aussi une affirmation de l'éditeur. Tous deux consultés le 14 septembre 2026.
Pour être honnête, l'auto-réparation change la façon dont un test trouve les éléments, et elle ne doit jamais changer ce que le test vérifie. Un localisateur réparé qui cible un élément semblable mais différent transforme un build vert en mensonge. Traitez chaque réparation comme une pull request : elle est proposée, relue et réversible, et le test doit échouer sur le build cassé avant que la réparation compte. La mécanique éditeur par éditeur, y compris ce que chacun expose pour la relecture et le retour arrière, est détaillée dans les tests de régression par l'IA.
L'exécution par agents est différente. Ici, le modèle pilote l'application vers un objectif et décide de chaque étape suivante. Playwright fournit des agents planificateur, générateur et réparateur, ajoutés dans la version 1.56, la 1.63 étant la version actuelle dans les notes de version. La documentation indique que les définitions des agents doivent être régénérées à chaque mise à jour de Playwright. Consulté le 14 septembre 2026.
Les agents sont forts quand le chemin est inconnu : explorer une nouvelle fonctionnalité, reproduire un rapport de bug vague ou écrire la première version d'un parcours. Ils conviennent mal à la régression, où vous voulez les mêmes étapes, les mêmes données et le même verdict à chaque exécution. TestGuild, dans son examen des agents à l'exécution, souligne que l'exécution par agents peut être plus lente et moins prévisible qu'un script. La conception pratique consiste à utiliser le modèle une fois, à l'écriture et au tri, puis à enregistrer l'exécution validée sous forme de code et à rejouer ce code sans modèle dans la boucle. Coût, vitesse et reproductibilité s'améliorent en même temps.
Là où l'IA échoue, et ce que les humains gardent
Les échecs sont les mêmes d'une équipe à l'autre, et aucun ne se corrige avec un meilleur prompt.
Absence de contexte métier. Un modèle lit le code et l'écran. Il ne sait pas qu'un remboursement au-delà d'un certain montant exige un second approbateur, ni quel segment de clients ne tolère pas un paiement lent. Il génère ce qui semble testable, pas ce qui est risqué.
Fausse assurance. Les tests et résumés générés ont l'air faire autorité. Une mauvaise cause racine énoncée clairement coûte plus cher que pas de cause du tout, car elle envoie quelqu'un sur la mauvaise piste avec conviction.
Assertions faibles. Le test le plus facile à générer navigue, attend et vérifie que la page s'est chargée. Il passe pour toujours et ne détecte rien.
Confidentialité et traitement des données. Les prompts qui contiennent des enregistrements de production, des jetons ou du code propriétaire sortent de votre périmètre. L'ISTQB cite la confidentialité et la sécurité des données comme un risque central de l'IA générative dans les tests. Décidez de ce qui peut être envoyé avant que quiconque commence, pas après.
Biais de priorisation. Un modèle de sélection entraîné sur les échecs passés continue de tester ce qui a déjà cassé. Le nouveau code sans historique reçoit moins d'attention, et c'est justement là que se cachent les régressions.
Non-déterminisme. La même demande peut produire des résultats différents selon les jours. C'est acceptable à l'écriture et inacceptable dans une porte de validation, c'est pourquoi le modèle doit rester hors de la boucle de rejeu.
Tests réécrits pour passer. Un agent à qui l'on demande de mettre la suite au vert peut affaiblir une assertion, allonger une attente ou sauter un cas. Protégez l'assertion en relecture et méfiez-vous des corrections étrangement rapides.
La décision de mise en production. Savoir si un défaut connu peut être livré est un jugement sur les utilisateurs, les contrats et le calendrier. Aucun modèle ne détient l'information nécessaire pour le faire.
L'article de Qt sur l'IA dans les tests résume bien la relation de travail : "L'avenir des tests logiciels n'est pas l'IA ou l'humain, tout comme il n'a jamais été le manuel ou l'automatisé." Consulté le 14 septembre 2026. En pratique, c'est une répartition du travail. L'IA fait le travail de volume, accompagné d'un contrôle mécanique peu coûteux. Les humains gardent le risque, l'ambiguïté, les limites des données et la décision de livrer.
Comment adopter l'IA en QA sans perdre le contrôle
Les équipes qui en tirent de la valeur commencent petit et mesurent. Celles qui n'y arrivent pas commencent par acheter une plateforme et espérer.
Choisissez un problème. Maintenance instable, pipelines lents, faible couverture unitaire ou tri bruyant. Choisissez celui qui vous coûte du temps ce mois-ci. Le conseil de TestGuild à ceux qui choisissent un outil est de "partir du problème, pas de la mode", et il s'applique avant même qu'un outil entre en jeu. Consulté le 14 septembre 2026.
Mesurez d'abord le point de départ. Notez le chiffre actuel : heures par semaine de maintenance des tests, minutes de durée du pipeline, pourcentage d'échecs réels. Sans point de départ, vous ne pouvez pas distinguer un bénéfice d'une belle histoire.
Faites le pilote sur un travail représentatif. Utilisez un vrai dépôt avec de vrais changements, pas une application d'exemple. Un outil qui ne voit qu'une interface stable ne vous apprend rien sur la maintenance.
Gardez les preuves brutes. La requête en échec, la réponse, la capture, la trace. Un résumé écrit par le modèle est un point de départ pour l'enquête, jamais le compte rendu de ce qui s'est passé.
Exigez une relecture là où ça bloque. Tout ce qui peut bloquer une fusion est lu d'abord par une personne. Ce qui n'est qu'indicatif peut passer.
Tracez la ligne du déterminisme. Le modèle à l'écriture et au tri. Du code enregistré à l'exécution. Mettez cette frontière par écrit pour qu'elle survive au prochain outil.
Mesurez ensuite ce qui bouge si cela fonctionne.
Tests acceptés. Parmi les tests proposés par le modèle, combien ont passé la relecture et sont entrés dans la suite.
Défauts valides. Combien de vrais bugs sont venus du travail assisté par l'IA, séparés du bruit.
Temps de maintenance. Heures par semaine passées à réparer des tests, comparées au point de départ noté.
Taux d'instabilité. Part des exécutions qui échouent sans changement de code. L'exécution par agents tend à l'augmenter.
Défauts échappés. Les bugs arrivés en production. Si la sélection réduit la suite, c'est ce chiffre qui vous dit quand elle a trop coupé.
Les affirmations des éditeurs restent en dehors de tout cela. CloudBees affirme que Smart Tests priorise les tests susceptibles de détecter des échecs pertinents, classe les échecs et fournit un retour aux développeurs jusqu'à 80 % plus vite. Consulté le 14 septembre 2026. C'est le chiffre de l'éditeur lui-même, pas un benchmark. Ce sont les chiffres de votre pilote qui décident.
Tester le code avec l'IA : des tests pour du code écrit par une IA
"Tester le code avec l'IA" recouvre deux choses. La première consiste à utiliser l'IA pour écrire des tests pour votre code, comme des tests unitaires générés dans l'éditeur ; les filtres de la section sur la génération ci-dessus s'appliquent. La seconde consiste à tester du code écrit par un assistant d'IA. Ce code doit répondre à la même exigence que celui de n'importe qui : relecture, tests qui s'exécutent et vérification sur l'application en marche, car un modèle peut produire du code qui se lit bien et renvoie la mauvaise réponse. Notre guide de la revue de code automatisée couvre le volet relecture.
Ce que coûtent les outils de test par l'IA
Les prix, relevés sur la page de chaque éditeur le 11 novembre 2026, montrent quatre modèles de facturation. Comparez-les sur votre propre nombre d'exécutions mensuelles.
| Outil | Ce que fait l'IA | Prix |
|---|---|---|
| Qodex | Un agent écrit des tests d'API, d'interface et de sécurité à partir d'une phrase, puis les rejoue sous forme de scripts | Individual 0 $ avec 25 scénarios et 100 exécutions par mois ; Startup à partir de 1 299 $ par projet et par mois |
| QA Wolf | Des agents écrivent des tests Playwright et Appium et les réparent | 1 $ par exécution web de 5 minutes maximum, sans frais par siège |
| Momentic | Écriture de tests par l'IA et auto-réparation | Gratuit avec 50 $ d'usage par mois ; Scale 500 $ par mois |
| Autify | L'agent Aximo teste les applications web et mobiles | Individual 0 $ avec 2 000 crédits uniques ; Core 99 $ par mois en facturation annuelle |
| mabl | Tests low-code avec assistance de l'IA | Aucun prix public ; essai de 14 jours |
Là où d'autres conviennent mieux : Qodex teste les applications web et les API, pas les applications mobiles natives, donc Autify, Momentic ou QA Wolf conviennent mieux à une équipe centrée sur le mobile. Sources : QA Wolf, Momentic, Autify, mabl et Qodex.
Vous voulez voir le test par l'IA sur votre propre application ? Commencez gratuitement avec Qodex et décrivez un parcours.
Questions fréquentes
Qu'est-ce que l'IA dans les tests logiciels ?
L'utilisation de l'IA pour soutenir le travail de test : rédiger des scénarios, écrire du code de test, construire des données, piloter l'application, réparer une automatisation cassée, comparer des rendus visuels, classer les tests par rapport à un changement et regrouper les échecs. Le programme CT-GenAI de l'ISTQB couvre ce terrain. C'est distinct du test d'un produit qui contient de l'IA, que couvre CT-AI v2.0.
Comment les testeurs QA utilisent-ils l'IA aujourd'hui ?
Surtout pour du travail de volume avec un contrôle peu coûteux à côté. Les testeurs s'en servent pour rédiger des cas de test à partir d'une exigence, générer des tests unitaires et de bout en bout et créer des données synthétiques. Elle propose aussi des réparations de localisateurs quand l'interface change et résume un mur d'échecs de CI en une courte liste. Le testeur décide de ce qui est risqué, relit ce que le modèle a produit et porte la décision de mise en production.
Quelle est la différence entre le test par l'IA et l'automatisation des tests ?
L'automatisation est déterministe par conception. Avec le même build, les mêmes données et le même environnement, un script exécute les mêmes étapes et rend le même verdict, et une personne le maintient. Changez l'un des trois et le résultat peut changer, c'est pourquoi il importe de contrôler ces entrées. L'IA est probabiliste d'une autre manière : elle propose, classe, répare et explique, et le résultat peut varier d'une exécution à l'autre avec des entrées identiques. Dans une configuration qui fonctionne, l'IA se place autour de l'automatisation, pas dans le chemin d'exécution, si bien que la porte de validation reste aussi reproductible que vos entrées. Pour voir comment l'automatisation des tests par l'IA fonctionne en pratique, et les indicateurs et le ROI auxquels la mesurer, lisez notre guide de l'automatisation des tests par l'IA.
L'IA peut-elle générer des cas de test fiables ?
Elle génère des candidats utiles qu'il faut filtrer. Dans l'évaluation de TestGen-LLM par Meta, 75 % des cas générés se sont compilés, 57 % sont passés de manière fiable et 25 % ont augmenté la couverture. Appliquez les mêmes filtres à vos propres résultats : il compile, il passe de façon répétée, il augmente la couverture, il vérifie quelque chose de réel, et une personne qui connaît la fonctionnalité le valide avant qu'il puisse bloquer une fusion.
Que sont les tests auto-réparateurs ?
Des tests qui proposent leur propre réparation quand l'interface change. Un modèle lit les attributs, le texte et le contexte visuel, détermine quel élément l'ancienne étape visait et suggère un nouveau localisateur ou une nouvelle étape. mabl et Applitools en proposent tous deux une version. La règle qui rend cela sûr : l'auto-réparation peut changer la façon dont un test trouve un élément, jamais ce que le test vérifie.
L'IA peut-elle faire des tests exploratoires ?
En partie. Un agent peut parcourir une nouvelle fonctionnalité, essayer des entrées qu'un script n'essaierait pas et faire apparaître des états que personne n'avait notés, ce qui est vraiment utile en terrain inconnu. Il ne peut pas formuler d'hypothèse sur ce qui nuirait à cette entreprise, et il ne remarque pas qu'une chose est techniquement correcte mais mauvaise pour l'utilisateur. Traitez les exécutions d'agents comme une matière première pour un testeur, pas comme un remplaçant.
L'IA va-t-elle remplacer les testeurs QA ?
Non, et le travail qui disparaît n'est pas celui qui compte. Rédiger des cas répétitifs, réparer des localisateurs et lire des logs diminue. Décider de ce qui est risqué, interpréter un comportement ambigu, débattre de la possibilité de livrer un défaut et concevoir l'assertion qui attrape vraiment le bug ne diminue pas. Les testeurs capables de diriger et d'auditer ce que produit le modèle finissent par faire davantage de la moitié intéressante.
Quels sont les risques de l'IA dans les tests logiciels ?
Des tests qui passent sans rien vérifier. Des réparations qui ciblent le mauvais élément et transforment un build vert en mensonge. Des explications d'échecs assurées mais fausses. Des données de production et du code source envoyés dans un prompt. Une priorisation qui continue de tester ce qui a déjà cassé et ignore le nouveau code. Des résultats qui varient d'une exécution à l'autre. Les parades diffèrent selon le risque. Les assertions faibles, les mauvaises réparations et les résultats qui dérivent sont attrapés par des filtres mécaniques : relecture des assertions, un écart de couverture, un test qui doit échouer sur le build cassé, une suite complète planifiée derrière tout sous-ensemble classé. La confidentialité, les biais et la décision de mise en production, non. Ceux-là exigent une règle écrite sur ce qui peut être envoyé, une personne qui surveille ce que le classement cesse de tester et un responsable humain de la décision de livrer.
Le test par l'IA est-il un outil, un service ou une capacité ?
Une capacité que vous pouvez acheter sous chacune de ces formes. Les plateformes la vendent comme des fonctionnalités dans un produit. Les agences la vendent comme un service de test assisté par l'IA. L'open source vous la donne directement, comme avec les agents planificateur, générateur et réparateur de Playwright. Ce que vous achetez vraiment, c'est la place du modèle dans votre flux de travail et la personne qui relit ses résultats : jugez chacune des trois options sur ce point.
Existe-t-il une règle reconnue des 30 % pour l'IA dans les tests ?
Non. L'expression apparaît dans les suggestions de recherche, mais aucune norme de test, aucun programme ni aucun organisme crédible ne définit une règle des 30 %, et les chiffres qu'on y rattache varient selon qui la cite. Ignorez-la. Décidez de la part de votre travail de test que l'IA touche en mesurant les tests acceptés, les défauts valides, les heures de maintenance et les défauts échappés sur votre propre suite.