KI im Softwaretesting: Was sie heute leistet
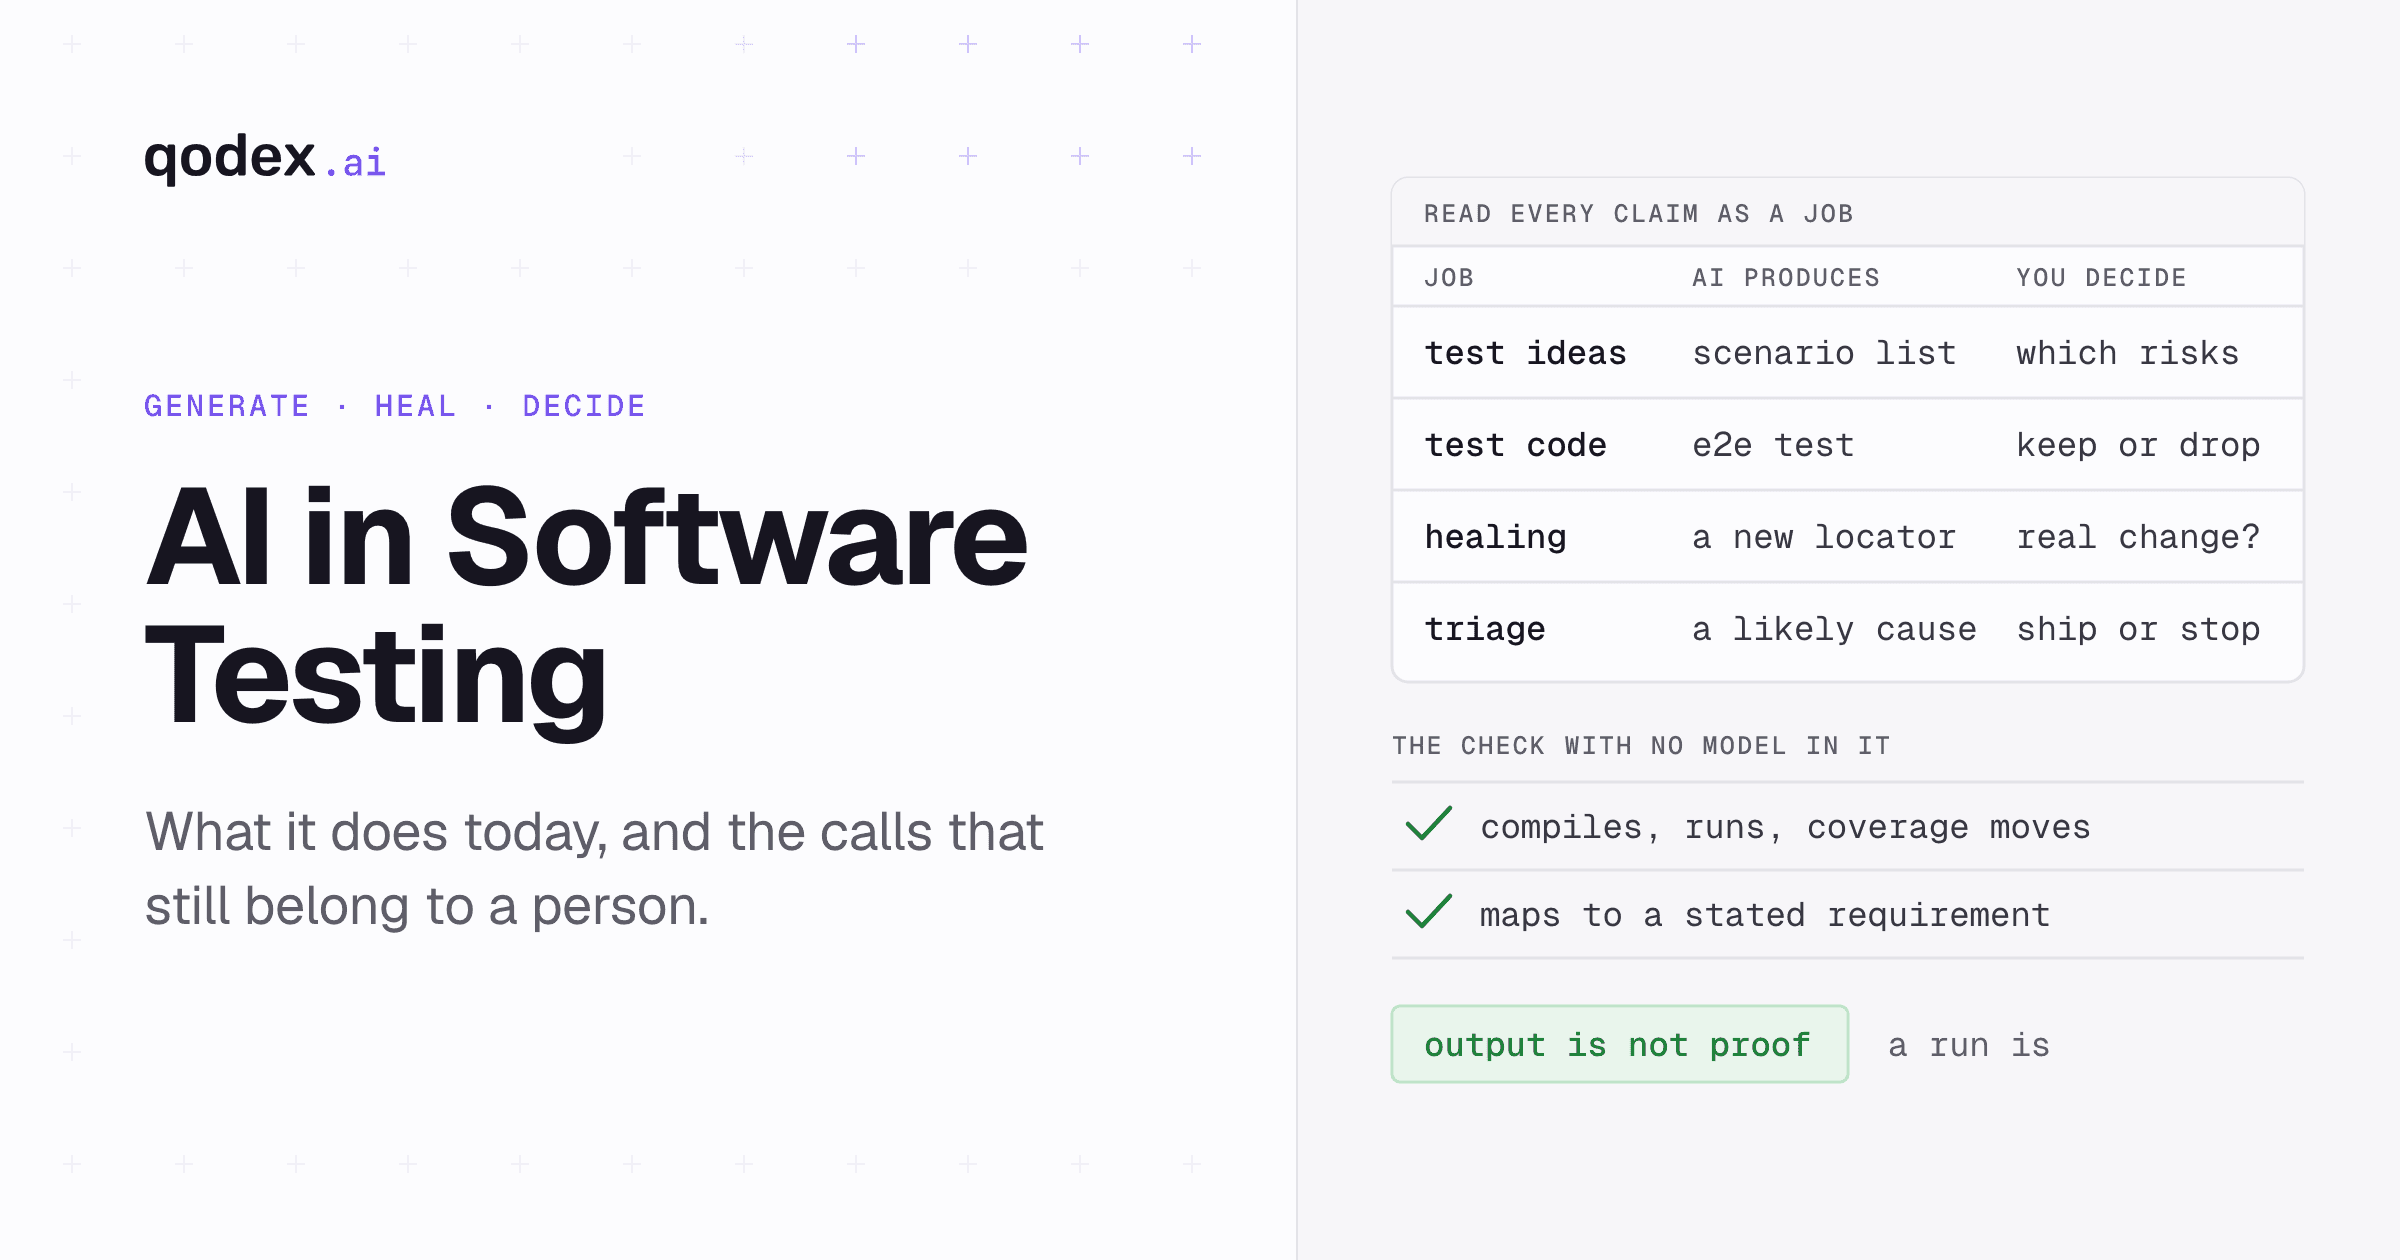
KI im Softwaretesting hilft Teams, Testfälle zu entwerfen, Daten und Skripte zu erzeugen, auszuwählen, welche Tests laufen, Automatisierung anzupassen, wenn sich die Oberfläche verschiebt, visuelle Ergebnisse zu vergleichen und Fehlschläge zu untersuchen. Am besten funktioniert sie als Assistent rund um deterministische Prüfungen, nicht als Richter darüber, ob die Software gut genug ist. Menschen legen weiterhin das Risiko fest, deuten mehrdeutiges Verhalten, schützen sensible Daten und entscheiden, ob die Belege ein Release tragen.
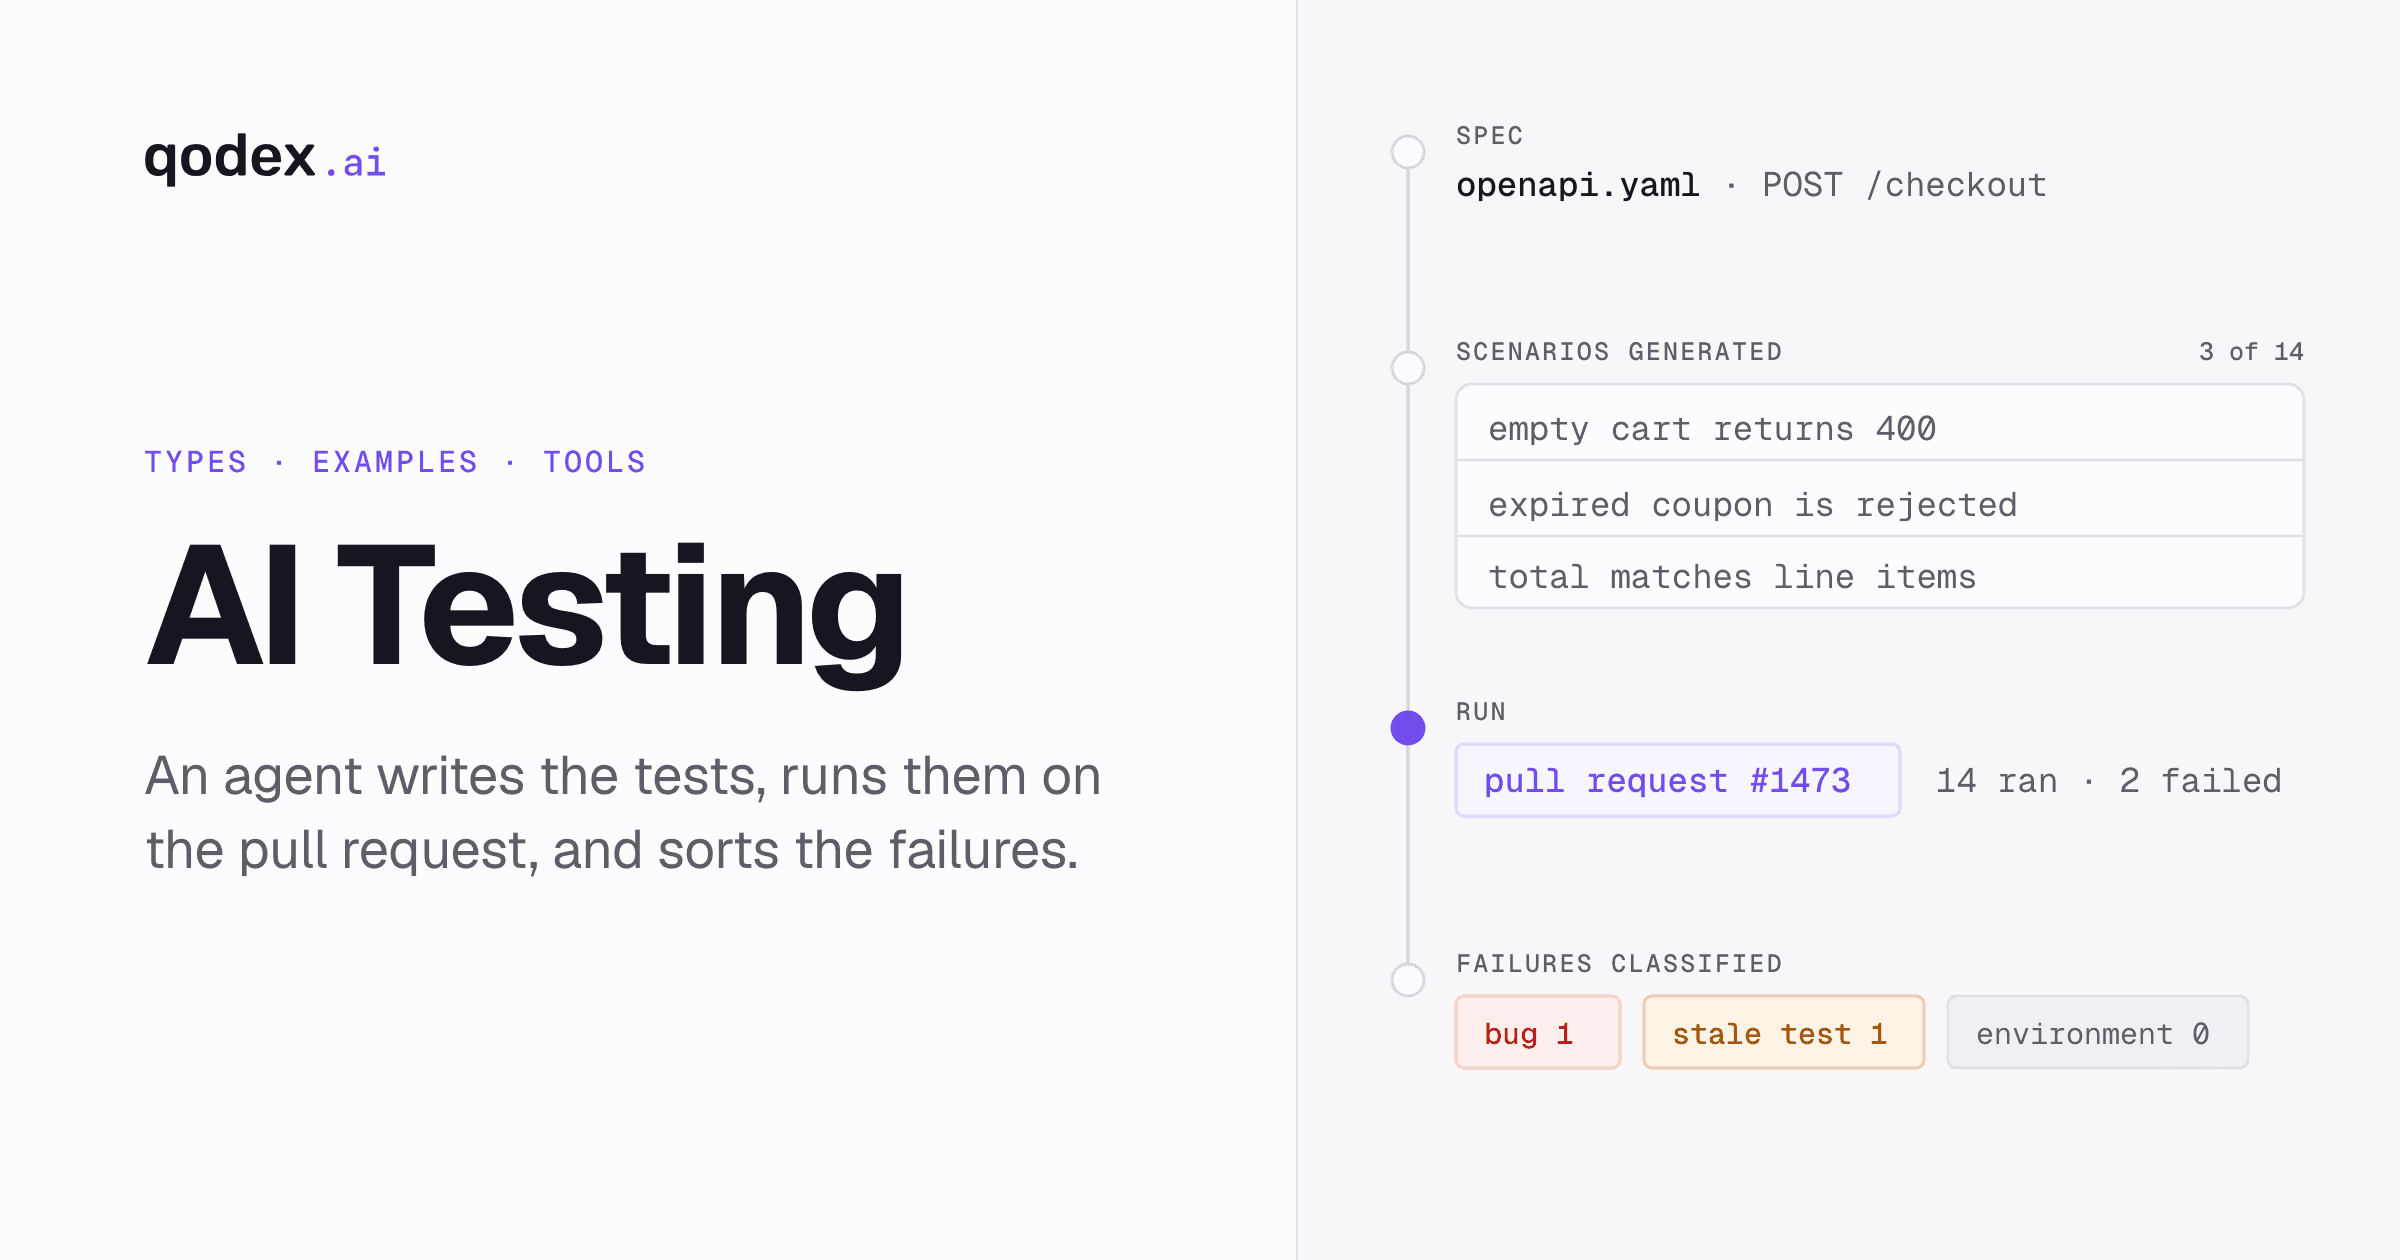
Beschreiben Sie den Ablauf in einem Satz. Qodex steuert die echte App, bringt einen Screenshot dessen zurück, was kaputtging, und speichert den Lauf als Playwright-Code, der Ihnen gehört.
Diese Seite erklärt, was die Technik heute tatsächlich leistet. Wenn Sie ein Tool suchen, vergleicht die Übersicht der besten KI-QA-Tools die Produkte, einschließlich No-Code-Plattformen wie mabl und ihrer nahen Verwandten. Der Leitfaden zu KI-QA behandelt die zugrunde liegenden Techniken aus Machine Learning, Sprache und Bildverarbeitung, und KI-Regressionstests zeigt, was all das in einer Regressionssuite bedeutet. Diese Seite bleibt auf der Ebene der Aufgaben: was die KI tut, was sie prüft und was weiterhin ein Mensch entscheidet.
Wo Sie KI im Testen einsetzen sollten
| Frage | Warum es wichtig ist | Wie es gut aussieht |
|---|---|---|
| Welcher Schmerz kostet Sie diesen Monat am meisten? | KI hilft am meisten bei einem konkreten Engpass | Wählen Sie einen: Tests schreiben, instabile Wartung, langsame Pipelines oder laute Triage |
| Ist das Ergebnis Code, den Sie behalten? | Ein Test in einem Anbieterformat lässt sich schwer prüfen oder umziehen | Lesbare Skripte in einem Standard-Framework, in git abgelegt |
| Ruft jeder Neustart ein Modell auf? | Modellaufrufe bei jedem Lauf machen Kosten und Ergebnisse schwankend | Das Modell schreibt den Test einmal; Neustarts spielen ein festes Skript ab |
| Wer gibt frei, was die KI geschrieben hat? | Erzeugte Tests können grün sein und nichts prüfen | Neue Tests starten als Entwurf, bis ein Mensch sie übernimmt |
| Welche Daten sieht sie? | Staging-Daten und Zugangsdaten verlassen Ihr Netzwerk | SOC 2 oder ISO 27001, Kontrollen zur Datenaufbewahrung, bei Bedarf Ihr eigener Modellschlüssel |
Was KI im Softwaretesting bedeutet
Zwei verschiedene Aufgaben tragen denselben Namen. Die eine ist, KI für Testarbeit zu nutzen. Die andere ist, ein Produkt zu testen, in dem KI steckt. ISTQB trennt beides, und diese Trennung hilft beim Lesen jeder Anbieterseite.
KI für das Testen nutzen. Der CT-GenAI-Lehrplan behandelt Tester, die generative KI in Anforderungsanalyse, Testdesign, Automatisierung und Reporting einsetzen, und nennt Halluzinationen, Denkfehler, Verzerrungen, Datenschutz und Sicherheit sowie Energieverbrauch als die zu steuernden Risiken. Abgelesen am 14. September 2026.
KI-Systeme testen. Der CT-AI-v2.0-Lehrplan behandelt das Testen KI-basierter Systeme, darunter Machine-Learning-Systeme und große Sprachmodelle, mit Tests der Eingabedaten, Modelltests und Tests der ML-Entwicklung. Er befasst sich mit probabilistischem Verhalten, Nichtdeterminismus, Daten, Modellen und Qualitätsmerkmalen des Systems unter Test, also mit anderen Problemen als denen auf dieser Seite. Abgelesen am 14. September 2026.
Diese Seite handelt von der ersten Aufgabe. Innerhalb davon werden vier verschiedene Techniken KI genannt, und sie verhalten sich unterschiedlich.
Generative Unterstützung. Ein Sprachmodell entwirft Pläne, Fälle, Skripte, Daten und Zusammenfassungen. Das Ergebnis ist probabilistisch, derselbe Prompt kann morgen also etwas anderes liefern.
Klassifizierung und Priorisierung. Ein Modell ordnet Tests nach einer Änderung, gruppiert ähnliche Fehlschläge und markiert Muster, die instabil wirken.
Computer Vision. Gerenderte Seiten werden auf Layout- und Darstellungsunterschiede verglichen, statt DOM-Attribute einzeln zu prüfen.
Laufzeit-Agenten. Ein Modell steuert die Anwendung, entscheidet den nächsten Schritt und reagiert auf das, was es sieht, statt ein festes Skript abzuspielen.
Fragen Sie, welche der vier Techniken eine Funktion nutzt. Die Antwort sagt voraus, wie wiederholbar sie ist, wie Sie sie validieren und was ihr Betrieb kostet.
Was KI im Testlebenszyklus tut
Jede Behauptung zu KI-Testing liest man am besten als Aufgabe mit einer Eingabe, einem Ergebnis, einer Prüfung ohne Modell und einer Entscheidung, die bei einem Menschen bleibt. Die Tabelle unten tut das für die Arbeit, die KI heute berührt.
| Testaufgabe | Eingabe, die die KI braucht | Ergebnis der KI | Deterministische Prüfung | Entscheidung des Menschen | Passt am besten zu | Hauptrisiko |
|---|---|---|---|---|---|---|
| Anforderungen in Testideen übersetzen | Anforderung, Nutzerablauf, Zugang zur App | Liste von Szenarien mit Randfällen | Jedes Szenario lässt sich einer genannten Anforderung zuordnen | Welche Risiken für dieses Release zählen | Neue oder schlecht dokumentierte Features | Plausible Szenarien, die das echte Risiko verfehlen |
| Einen Testplan entwerfen | Umfang, Umgebung, ein Ausgangstest | Lesbarer Plan mit Schritten und Daten | Der Plan läuft einmal von Hand komplett durch | Abdeckung und Tiefe je Bereich | Regressionsplanung für eine bekannte App | Abdeckung, die vollständig klingt, es aber nicht ist |
| Ausführbare Tests erzeugen | Quellcode, Plan, Beispiele | Unit- oder End-to-End-Testcode | Kompilieren, ausführen, Abdeckungszuwachs, Prüfung der Assertions | Ob der Test in die Suite gehört | Unit-Tests und Happy-Path-Abläufe | Tests, die grün sind, ohne etwas zu prüfen |
| Testdaten bauen | Schema, Einschränkungen, Menge | Synthetische Datensätze und Fixtures | Validierung gegen Schema und Einschränkungen | Welche Produktionsdaten das Haus verlassen dürfen | Lastdaten und Datensätze für Randfälle | Echte Daten, die in einen Prompt gelangen |
| Die Anwendung zur Laufzeit steuern | Zugang zur App, Ziel in Worten | Ein abgeschlossener oder gescheiterter Lauf | Screenshot, Netzwerkprotokoll, Exit-Code | Ob eine Abweichung ein Bug ist | Erkundung und erste Fassung eines Tests | Langsamer und weniger wiederholbar als ein Skript |
| Kaputte Automatisierung reparieren | Fehlschlagender Test, Seitenzustand, Verlauf | Vorgeschlagene Änderung an Locator oder Schritt | Test schlägt auf dem alten Build fehl und läuft auf dem neuen durch | Annehmen, ablehnen oder untersuchen | Kosmetische und strukturelle UI-Änderungen | Eine Reparatur, die stillschweigend das falsche Element trifft |
| Visuelle Ausgabe vergleichen | Baseline und aktuelle Darstellung | Abweichende Bereiche und ein Urteil | Baseline von einem Menschen freigegeben | Ob der Unterschied gewollt ist | Layout- und Cross-Browser-Regressionen | Rauschen wird so lange herausgefiltert, bis echte Fehler durchrutschen |
| Tests für eine Änderung auswählen | Diff, Verlauf, Abdeckungsdaten | Gerangte Teilmenge, die jetzt laufen soll | Komplette Suite nach Zeitplan als Absicherung | Ob die Teilmenge für den Merge reicht | Große Suiten und langsame Pipelines | Übersehene Regression außerhalb der gerangten Menge |
| Fehlschläge einordnen und zusammenfassen | Logs, Traces, Screenshots, Verlauf | Gruppierte Fehlschläge und eine vermutete Ursache | Das rohe Fehlerartefakt bleibt der Beleg | Die echte Ursache und die Korrektur | Laute CI mit wiederholten Fehlschlägen | Eine selbstsichere Zusammenfassung, die falsch ist |
Die Planung liegt vor all dem, und ihre Mechanik behandelt der Leitfaden zur Erstellung eines Testplans. Auf der API-Seite ist das Erzeugen von Tests die reifste Anwendung, durchgespielt in API-Tests mit KI in 30 Minuten automatisieren und im umfassenderen Leitfaden zum API-Testing. Auswahl und Triage zahlen sich in der Pipeline aus, und dort setzen KI-Regressionstests und aktuelle CI/CD-Trends an.
Testgenerierung: Nützliches Ergebnis ist kein Beweis
Die Generierung ist der eine Bereich mit veröffentlichten unabhängigen Belegen, und diese Belege sind konkret, nicht pauschal.
Meta setzte sein System TestGen-LLM bei Reels und Stories auf Instagram ein. Von den erzeugten Testfällen ließen sich 75% korrekt bauen, 57% liefen zuverlässig durch und 25% erhöhten die Abdeckung. Das sind Auswertungsergebnisse aus einem einzigen Einsatz, keine Erfolgsquote, die Sie für Ihren eigenen Code erwarten sollten. Abgelesen am 14. September 2026.
CoverUp, ein Testgenerator für Python, der Abdeckungslücken zurück in den Prompt gibt, erreichte pro Modul eine mittlere Zeilen- und Zweigabdeckung von 80% gegenüber 47% bei CodaMosa und insgesamt 89% gegenüber 77% bei MuTAP. Auch das sind Benchmark-Zahlen auf Open-Source-Modulen. Abgelesen am 14. September 2026.
Lesen Sie beide Ergebnisse gleich. Ein Modell kann schnell viel Testcode schreiben, und ein spürbarer Teil davon ist falsch, schwach oder überflüssig. Das ist in Ordnung, denn die Filter sind billig und mechanisch.
Er kompiliert. Alles, was nicht baut, wird verworfen, ohne dass ein Mensch es ansieht.
Er läuft und ist wiederholt grün. Führen Sie jeden Kandidaten mehrmals aus. Verwerfen Sie alles, was flackert.
Er erhöht die Abdeckung. Behalten Sie den Kandidaten nur, wenn er Zeilen oder Zweige abdeckt, die der Suite fehlten.
Er prüft etwas. Ein Test, der Code ausführt, ohne das Ergebnis zu prüfen, ist ein falsches Signal. Das Entwerfen von Assertions ist eine eigene Fähigkeit, behandelt im Leitfaden zu Playwright-Assertions.
Ein Mensch gibt ihn frei. Jemand, der das Feature kennt, liest den Test, bevor er einen Merge blockieren darf.
Die Generierung beginnt auch früher als beim Code. Der Planner-Agent von Playwright erkundet eine laufende App und schreibt einen Markdown-Plan, den Sie lesen können, bevor daraus etwas erzeugt wird; er braucht dafür eine klare Anfrage und einen Ausgangstest. Damit hat ein Mensch einen Prüfpunkt, bevor die Testgenerierung beginnt. Quelle: Playwright Test Agents, abgelesen am 14. September 2026.
Werkzeuge bauen die Prüfstufen zunehmend ein. GitHub dokumentiert die Erzeugung von Unit-Tests als Copilot-Workflow, und der Generator-Agent von Playwright prüft Selektoren und Assertions live gegen die laufende App, während er den Test schreibt. Beide abgelesen am 14. September 2026. Keines von beiden ersetzt die Prüfung durch einen Menschen.
Self-Healing und agentische Ausführung
Zwei Fähigkeiten werden verwechselt, weil beide zur Laufzeit ein Modell einsetzen.
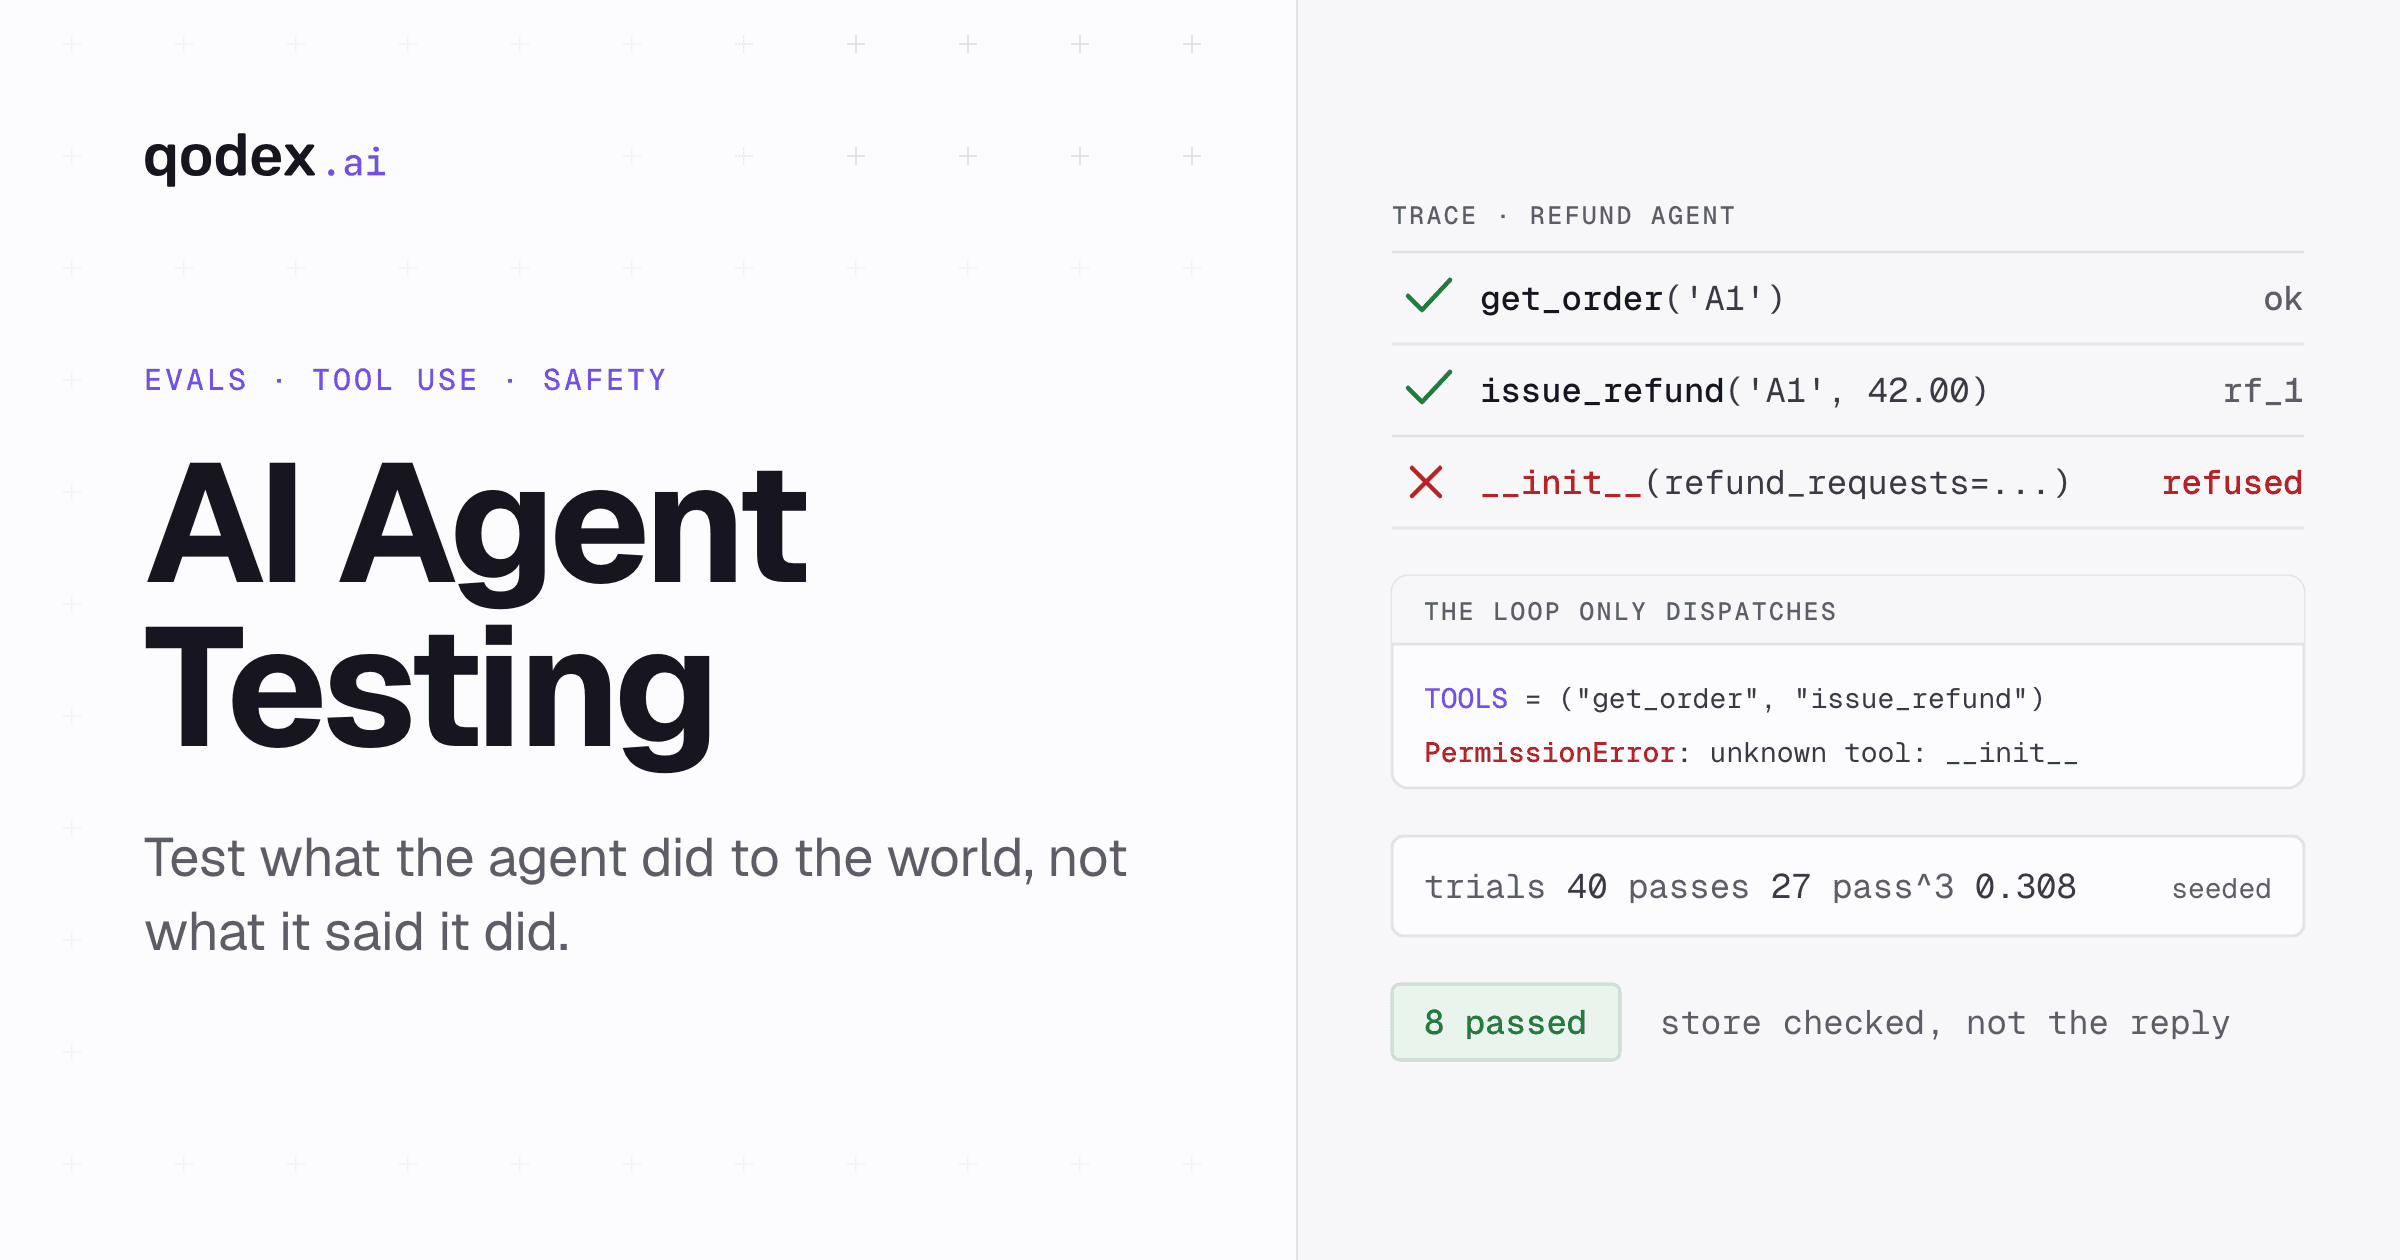
Wer ein KI-Feature baut, schafft sich ein zweites QA-Problem: den KI-Agenten testen, über seine Tools, mehrstufigen Entscheidungen, Leitplanken und wiederholten Läufe hinweg.
Self-Healing repariert Automatisierung, die kaputtging, weil sich die Oberfläche verschoben hat. Wenn ein Button seine Attribute ändert, nutzt ein Modell die umliegenden Attribute, den sichtbaren Text und den visuellen Kontext, um einen neuen Locator oder Schritt vorzuschlagen. mabl beschreibt einen Agenten, der Tests selbstständig aktualisiert und einen Menschen nach dem Grund für eine Aktion fragt, wenn er diesen Kontext braucht. Die Aussage, bis zu 95% der Testwartung zu beseitigen, ist die eigene Zahl des Anbieters, veröffentlicht ohne Methode. Applitools sagt, seine Locators fänden ein geändertes Element über visuelle und semantische Hinweise und seine Visual AI erkenne Darstellungs- und Layout-Regressionen. Auch das ist eine Aussage des Anbieters. Beide abgelesen am 14. September 2026.
Ehrlich gesagt ändert Self-Healing, wie ein Test Dinge findet, und es darf nie ändern, was ein Test prüft. Ein reparierter Locator, der ein ähnliches, aber anderes Element trifft, macht aus einem grünen Build eine Lüge. Behandeln Sie jede Reparatur wie einen Pull Request: Sie wird vorgeschlagen, geprüft und ist umkehrbar, und der Test muss auf dem kaputten Build fehlschlagen, bevor die Reparatur zählt. Die Mechanik je Anbieter, einschließlich dessen, was jeder für Prüfung und Rücknahme offenlegt, steht in KI-Regressionstests.
Agentische Ausführung ist etwas anderes. Hier steuert das Modell die App auf ein Ziel zu und entscheidet jeden nächsten Schritt. Playwright liefert Planner-, Generator- und Healer-Agenten, eingeführt in Version 1.56, aktuell ist laut Release Notes 1.63. Die Dokumentation weist darauf hin, dass die Agent-Definitionen bei jedem Playwright-Update neu erzeugt werden sollten. Abgelesen am 14. September 2026.
Agenten sind stark, wo der Weg unbekannt ist: beim Erkunden eines neuen Features, beim Nachstellen eines vagen Bugreports oder beim Schreiben der ersten Fassung eines Ablaufs. Für Regressionstests passen sie schlecht, denn dort wollen Sie bei jedem Lauf dieselben Schritte, dieselben Daten und dasselbe Urteil. TestGuild weist in seiner Besprechung von Laufzeit-Agenten darauf hin, dass agentische Ausführung langsamer und weniger vorhersehbar sein kann als ein Skript. Das praktische Design: Setzen Sie das Modell einmal ein, beim Schreiben und bei der Triage, speichern Sie dann den freigegebenen Lauf als Code und spielen Sie diesen Code ohne Modell ab. Kosten, Geschwindigkeit und Wiederholbarkeit verbessern sich dadurch gleichzeitig.
Wo KI scheitert und was Menschen weiterhin verantworten
Die Fehler sind in allen Teams gleich, und keiner davon lässt sich mit einem besseren Prompt beheben.
Fehlender Geschäftskontext. Ein Modell liest den Code und den Bildschirm. Es weiß nicht, dass eine Erstattung über einem bestimmten Betrag eine zweite Freigabe braucht, oder welches Kundensegment einen langsamen Checkout nicht verträgt. Es erzeugt, was testbar aussieht, nicht, was riskant ist.
Falsche Sicherheit. Erzeugte Tests und erzeugte Zusammenfassungen klingen maßgeblich. Eine klar formulierte falsche Ursache kostet mehr als gar keine, weil sie jemanden mit Überzeugung auf den falschen Weg schickt.
Schwache Assertions. Der am leichtesten zu erzeugende Test navigiert, wartet und prüft, ob die Seite geladen wurde. Er ist für immer grün und fängt nichts.
Datenschutz und Datenumgang. Prompts, die Produktionsdatensätze, Tokens oder proprietären Quellcode enthalten, verlassen Ihr Haus. ISTQB nennt Datenschutz und Sicherheit als zentrales Risiko generativer KI im Testen. Entscheiden Sie, was gesendet werden darf, bevor jemand anfängt, nicht danach.
Verzerrung bei der Priorisierung. Ein Auswahlmodell, das auf vergangenen Fehlschlägen trainiert ist, testet weiter, was schon einmal kaputtging. Neuer Code ohne Verlauf bekommt weniger Aufmerksamkeit, und genau dort verstecken sich Regressionen.
Nichtdeterminismus. Dieselbe Anfrage kann an verschiedenen Tagen verschiedene Ergebnisse liefern. Beim Schreiben ist das akzeptabel, in einer Prüfstufe nicht, und deshalb gehört das Modell nicht in die Abspielschleife.
Tests, die umgeschrieben werden, damit sie grün sind. Ein Agent, der die Suite grün machen soll, kann eine Assertion abschwächen, ein Warten verlängern oder einen Fall überspringen. Schützen Sie die Assertion im Review und achten Sie auf verdächtig schnelle Korrekturen.
Die Release-Entscheidung. Ob ein bekannter Fehler ausgeliefert werden kann, ist ein Urteil über Nutzer, Verträge und Timing. Kein Modell hat die Informationen, die dafür nötig sind.
Qts Beitrag zu KI im Testen beschreibt die Zusammenarbeit treffend: "Die Zukunft des Softwaretestens ist nicht KI oder Mensch, so wie sie nie manuell oder automatisiert war." Abgelesen am 14. September 2026. Praktisch heißt das Arbeitsteilung. Die KI erledigt Masse, verbunden mit einer billigen mechanischen Prüfung. Menschen verantworten Risiko, Mehrdeutigkeit, Datengrenzen und die Entscheidung über die Auslieferung.
KI in der QA einführen, ohne die Kontrolle zu verlieren
Teams, die davon profitieren, fangen schmal an und messen. Teams, denen das nicht gelingt, kaufen zuerst eine Plattform und hoffen.
Wählen Sie einen Schmerz. Instabile Wartung, langsame Pipelines, dünne Unit-Abdeckung oder laute Triage. Wählen Sie den, der Sie diesen Monat Zeit kostet. TestGuilds Rat an Leser, die ein Tool wählen, lautet "beim Schmerz anfangen, nicht beim Hype", und er gilt, bevor überhaupt ein Tool im Spiel ist. Abgelesen am 14. September 2026.
Messen Sie zuerst den Ausgangswert. Schreiben Sie die aktuelle Zahl auf: Stunden pro Woche für Testwartung, Minuten Laufzeit der Pipeline, Anteil der Fehlschläge, die echt sind. Ohne Ausgangswert können Sie einen Nutzen nicht von einer Geschichte unterscheiden.
Testen Sie an repräsentativer Arbeit. Nehmen Sie ein echtes Repository mit echten Änderungen, keine Beispiel-App. Ein Tool, das nur eine stabile Oberfläche sieht, sagt Ihnen nichts über Wartung.
Bewahren Sie Rohbelege auf. Der fehlschlagende Request, die Response, der Screenshot, der Trace. Eine vom Modell geschriebene Zusammenfassung ist ein Ausgangspunkt für die Untersuchung und nie der Nachweis dessen, was passiert ist.
Verlangen Sie ein Review, wo etwas blockiert. Alles, was einen Merge blockieren kann, liest zuerst ein Mensch. Alles, was nur berät, darf durchlaufen.
Ziehen Sie die Determinismus-Grenze. Modell beim Schreiben und bei der Triage. Gespeicherter Code bei der Ausführung. Schreiben Sie diese Grenze auf, damit sie das nächste Tool überdauert.
Messen Sie dann die Größen, die sich bewegen, wenn es funktioniert.
Angenommene Tests. Wie viele der vom Modell vorgeschlagenen Tests das Review überstanden haben und in der Suite gelandet sind.
Gültige Fehler. Wie viele echte Bugs aus KI-gestützter Arbeit kamen, getrennt vom Rauschen.
Wartungszeit. Stunden pro Woche für das Reparieren von Tests, verglichen mit dem notierten Ausgangswert.
Flake-Rate. Anteil der Läufe, die ohne Codeänderung fehlschlagen. Agentische Ausführung treibt diesen Wert eher nach oben.
Entkommene Fehler. Bugs, die die Produktion erreicht haben. Wenn die Auswahl die Suite verkleinert, zeigt Ihnen diese Zahl, wann sie zu viel weggeschnitten hat.
Anbieteraussagen stehen außerhalb von all dem. CloudBees sagt, Smart Tests priorisiere Tests, die wahrscheinlich relevante Fehler finden, ordne Fehlschläge ein und liefere Entwicklern Rückmeldung bis zu 80% schneller. Abgelesen am 14. September 2026. Das ist die eigene Zahl des Anbieters, kein Benchmark. Entscheidend sind die Zahlen aus Ihrem Pilotversuch.
KI-Code-Testing: Tests für Code, den eine KI geschrieben hat
"KI-Code-Testing" bedeutet zweierlei. Das eine ist, KI zu nutzen, um Tests für Ihren Code zu schreiben, etwa im Editor erzeugte Unit-Tests; dafür gelten die Prüfstufen aus dem Abschnitt zur Generierung oben. Das andere ist, Code zu testen, den ein KI-Assistent geschrieben hat. Dieser Code braucht dieselbe Messlatte wie jeder andere: Review, Tests, die laufen, und eine Prüfung an der laufenden App, denn ein Modell kann Code liefern, der gut aussieht und die falsche Antwort zurückgibt. Unser Leitfaden zum automatisierten Code-Review behandelt die Review-Seite.
Was KI-Testtools kosten
Die Preise, am 11. November 2026 auf der Seite jedes Anbieters abgelesen, zeigen vier Abrechnungsmodelle. Vergleichen Sie sie anhand Ihrer eigenen monatlichen Zahl von Läufen.
| Tool | Was die KI tut | Preis |
|---|---|---|
| Qodex | Ein Agent schreibt API-, UI- und Sicherheitstests aus einem Satz und spielt sie dann als Skripte ab | Individual 0 $ mit 25 Szenarien und 100 Ausführungen pro Monat; Startup ab 1.299 $ pro Projekt und Monat |
| QA Wolf | Agenten schreiben Playwright- und Appium-Tests und reparieren sie | 1 $ pro Web-Lauf von bis zu 5 Minuten, keine Gebühren pro Platz |
| Momentic | KI-gestütztes Schreiben von Tests und Auto-Healing | Kostenlos mit 50 $ Nutzung pro Monat; Scale 500 $ pro Monat |
| Autify | Der Agent Aximo testet Web- und Mobile-Apps | Individual 0 $ mit 2.000 einmaligen Credits; Core 99 $ pro Monat bei jährlicher Abrechnung |
| mabl | Low-Code-Tests mit KI-Unterstützung | Kein öffentlicher Preis; 14-tägige Testphase |
Wo andere besser passen: Qodex testet Web-Apps und APIs, keine nativen Mobile-Apps, daher passen Autify, Momentic oder QA Wolf besser zu einem Team, das mobil zuerst denkt. Quellen: QA Wolf, Momentic, Autify, mabl und Qodex.
Sie wollen KI-Testing an Ihrer eigenen App sehen? Starten Sie kostenlos mit Qodex und beschreiben Sie einen Ablauf.
Häufig gestellte Fragen
Was ist KI im Softwaretesting?
Der Einsatz von KI zur Unterstützung von Testarbeit: Szenarien entwerfen, Testcode schreiben, Daten bauen, die App steuern, kaputte Automatisierung reparieren, visuelle Ergebnisse vergleichen, Tests nach einer Änderung ordnen und Fehlschläge gruppieren. Der CT-GenAI-Lehrplan von ISTQB deckt dieses Feld ab. Davon getrennt ist das Testen eines Produkts, in dem KI steckt; das behandelt CT-AI v2.0.
Wie nutzen QA-Tester KI heute?
Meist für Massenarbeit mit einer billigen Prüfung dazu. Tester entwerfen damit Testfälle aus einer Anforderung, erzeugen Unit- und End-to-End-Tests und legen synthetische Daten an. Sie schlägt außerdem Locator-Reparaturen vor, wenn sich die UI ändert, und fasst eine Wand von CI-Fehlschlägen zu einer kurzen Liste zusammen. Der Tester entscheidet, was riskant ist, prüft, was das Modell geliefert hat, und trifft die Release-Entscheidung.
Was ist der Unterschied zwischen KI-Testing und Testautomatisierung?
Automatisierung ist von Grund auf deterministisch. Bei gleichem Build, gleichen Daten und gleicher Umgebung führt ein Skript dieselben Schritte aus und liefert dasselbe Urteil, und ein Mensch pflegt es. Ändert sich eines der drei, kann sich das Ergebnis ändern, deshalb ist die Kontrolle dieser Eingaben wichtig. KI ist auf andere Weise probabilistisch: Sie schlägt vor, ordnet, repariert und erklärt, und das Ergebnis kann bei identischen Eingaben von Lauf zu Lauf abweichen. In einem funktionierenden Aufbau sitzt die KI um die Automatisierung herum, nicht im Ausführungspfad, sodass die Prüfstufe so wiederholbar bleibt wie Ihre Eingaben. Wie KI-Testautomatisierung in der Praxis funktioniert und an welchen Kennzahlen und welchem ROI Sie sie messen, lesen Sie in unserem Leitfaden zur KI-Testautomatisierung.
Kann KI zuverlässige Testfälle erzeugen?
Sie erzeugt nützliche Kandidaten, die gefiltert werden müssen. In Metas Auswertung von TestGen-LLM ließen sich 75% der erzeugten Fälle bauen, 57% liefen zuverlässig durch und 25% erhöhten die Abdeckung. Wenden Sie dieselben Prüfstufen auf Ihre eigenen Ergebnisse an: Der Test kompiliert, ist wiederholt grün, erhöht die Abdeckung, prüft etwas Echtes, und ein Mensch, der das Feature kennt, gibt ihn frei, bevor er einen Merge blockieren kann.
Was sind selbstheilende Tests?
Tests, die ihre eigene Reparatur vorschlagen, wenn sich die Oberfläche ändert. Ein Modell liest Attribute, Text und visuellen Kontext, ermittelt, welches Element der alte Schritt meinte, und schlägt einen neuen Locator oder Schritt vor. mabl und Applitools liefern beide eine Version davon. Die Regel, die das sicher hält: Healing darf ändern, wie ein Test ein Element findet, und nie, was der Test prüft.
Kann KI explorative Tests ausführen?
Teilweise. Ein Agent kann ein neues Feature durchstreifen, Eingaben ausprobieren, die kein Skript versuchen würde, und Zustände aufdecken, die niemand aufgeschrieben hat; auf unbekanntem Terrain ist das wirklich nützlich. Er kann keine Hypothese darüber bilden, was diesem Geschäft schaden würde, und er merkt nicht, wenn etwas technisch korrekt, aber für den Nutzer falsch ist. Behandeln Sie Agenten-Läufe als Rohmaterial für einen Tester, nicht als Ersatz.
Wird KI QA-Tester ersetzen?
Nein, und die Arbeit, die wegfällt, ist nicht die Arbeit, die zählt. Standardfälle entwerfen, Locators reparieren und Logs lesen schrumpft. Entscheiden, was riskant ist, mehrdeutiges Verhalten deuten, darüber streiten, ob ein Fehler auslieferbar ist, und die Assertion entwerfen, die den Bug tatsächlich fängt, schrumpft nicht. Tester, die Modellergebnisse steuern und prüfen können, machen am Ende mehr von der interessanten Hälfte.
Welche Risiken hat KI im Softwaretesting?
Tests, die grün sind, ohne etwas zu prüfen. Reparaturen, die das falsche Element treffen und aus einem grünen Build eine Lüge machen. Selbstsichere, aber falsche Erklärungen für Fehlschläge. Produktionsdaten und Quellcode, die in einen Prompt gelangen. Eine Priorisierung, die weiter testet, was schon kaputtging, und neuen Code übersieht. Ergebnisse, die von Lauf zu Lauf schwanken. Die Gegenmaßnahmen unterscheiden sich je Risiko. Schwache Assertions, schlechte Reparaturen und abdriftende Ergebnisse fangen mechanische Prüfstufen ab: Review der Assertions, ein Abdeckungszuwachs, ein Test, der auf dem kaputten Build fehlschlagen muss, eine komplette Suite nach Zeitplan hinter jeder gerangten Teilmenge. Datenschutz, Verzerrung und die Release-Entscheidung nicht. Dafür braucht es eine schriftliche Regel, was gesendet werden darf, einen Menschen, der beobachtet, was die Rangfolge nicht mehr testet, und einen menschlichen Verantwortlichen für die Entscheidung zur Auslieferung.
Ist KI-Testing ein Tool, eine Dienstleistung oder eine Fähigkeit?
Eine Fähigkeit, die Sie in jeder dieser Formen kaufen können. Plattformen verkaufen sie als Funktionen in einem Produkt. Agenturen verkaufen sie als KI-gestützte Testdienstleistung. Open Source gibt sie Ihnen direkt, etwa mit den Planner-, Generator- und Healer-Agenten von Playwright. Was Sie tatsächlich kaufen, ist der Platz des Modells in Ihrem Workflow und die Frage, wer seine Ergebnisse prüft, also beurteilen Sie jede der drei Formen danach.
Gibt es eine anerkannte 30-%-Regel für KI im Testen?
Nein. Der Begriff taucht in Suchvorschlägen auf, aber kein Teststandard, kein Lehrplan und keine glaubwürdige Stelle definiert eine 30-%-Regel, und die Zahlen, die damit verbunden werden, hängen davon ab, wer sie zitiert. Ignorieren Sie sie. Entscheiden Sie, wie viel Ihrer Testarbeit KI berührt, indem Sie angenommene Tests, gültige Fehler, Wartungsstunden und entkommene Fehler in Ihrer eigenen Suite messen.