IA en las pruebas de software: lo que hace hoy
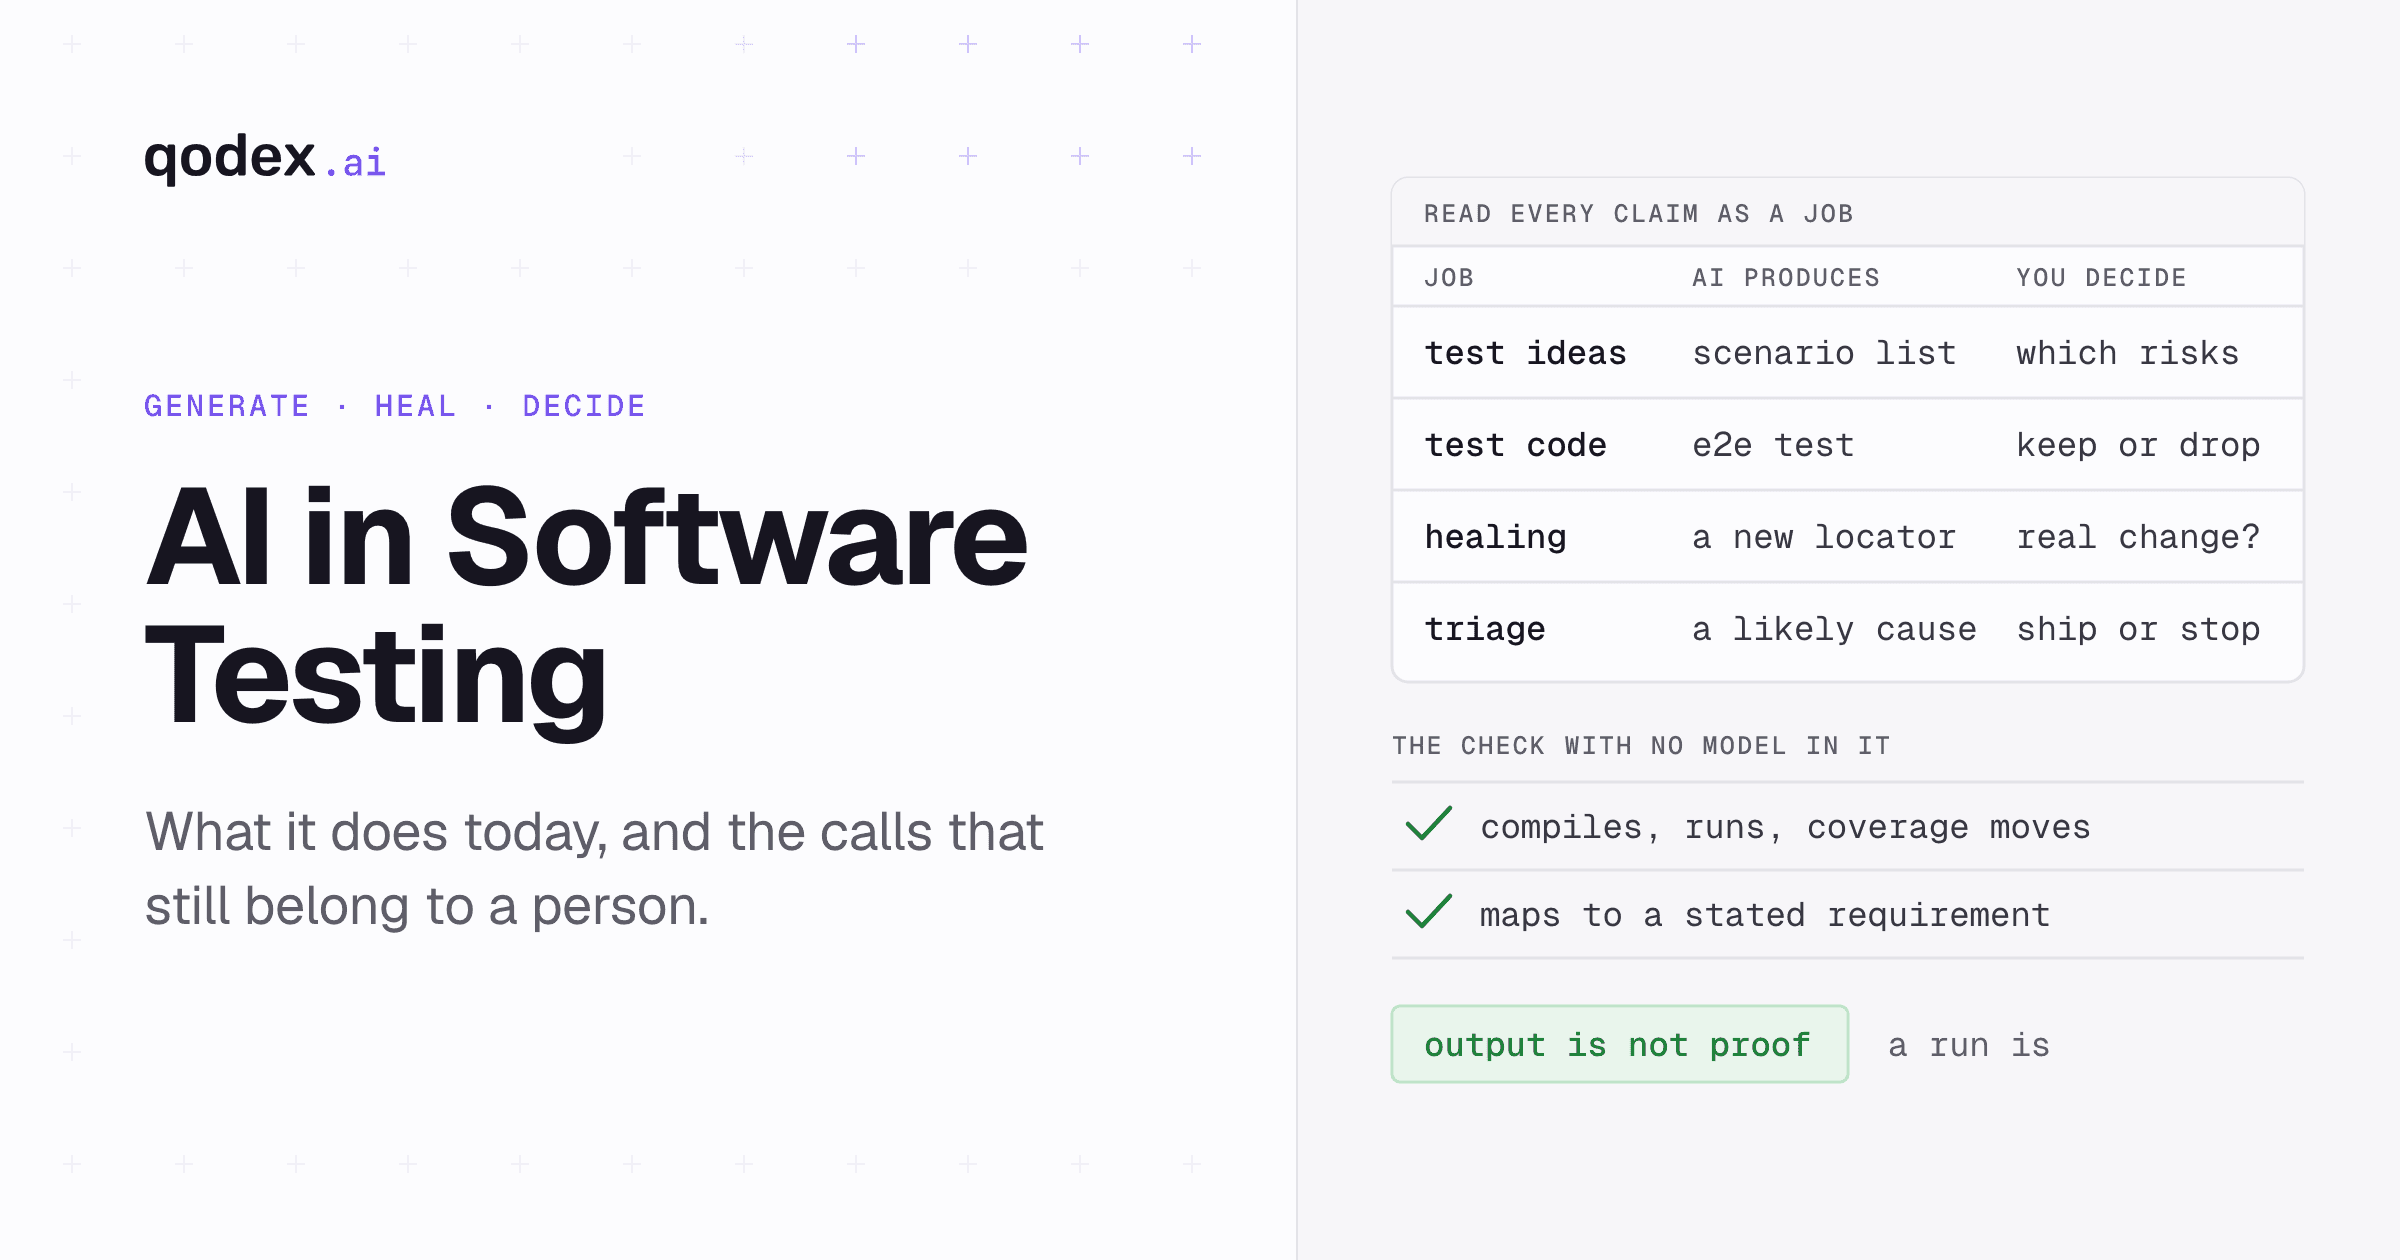
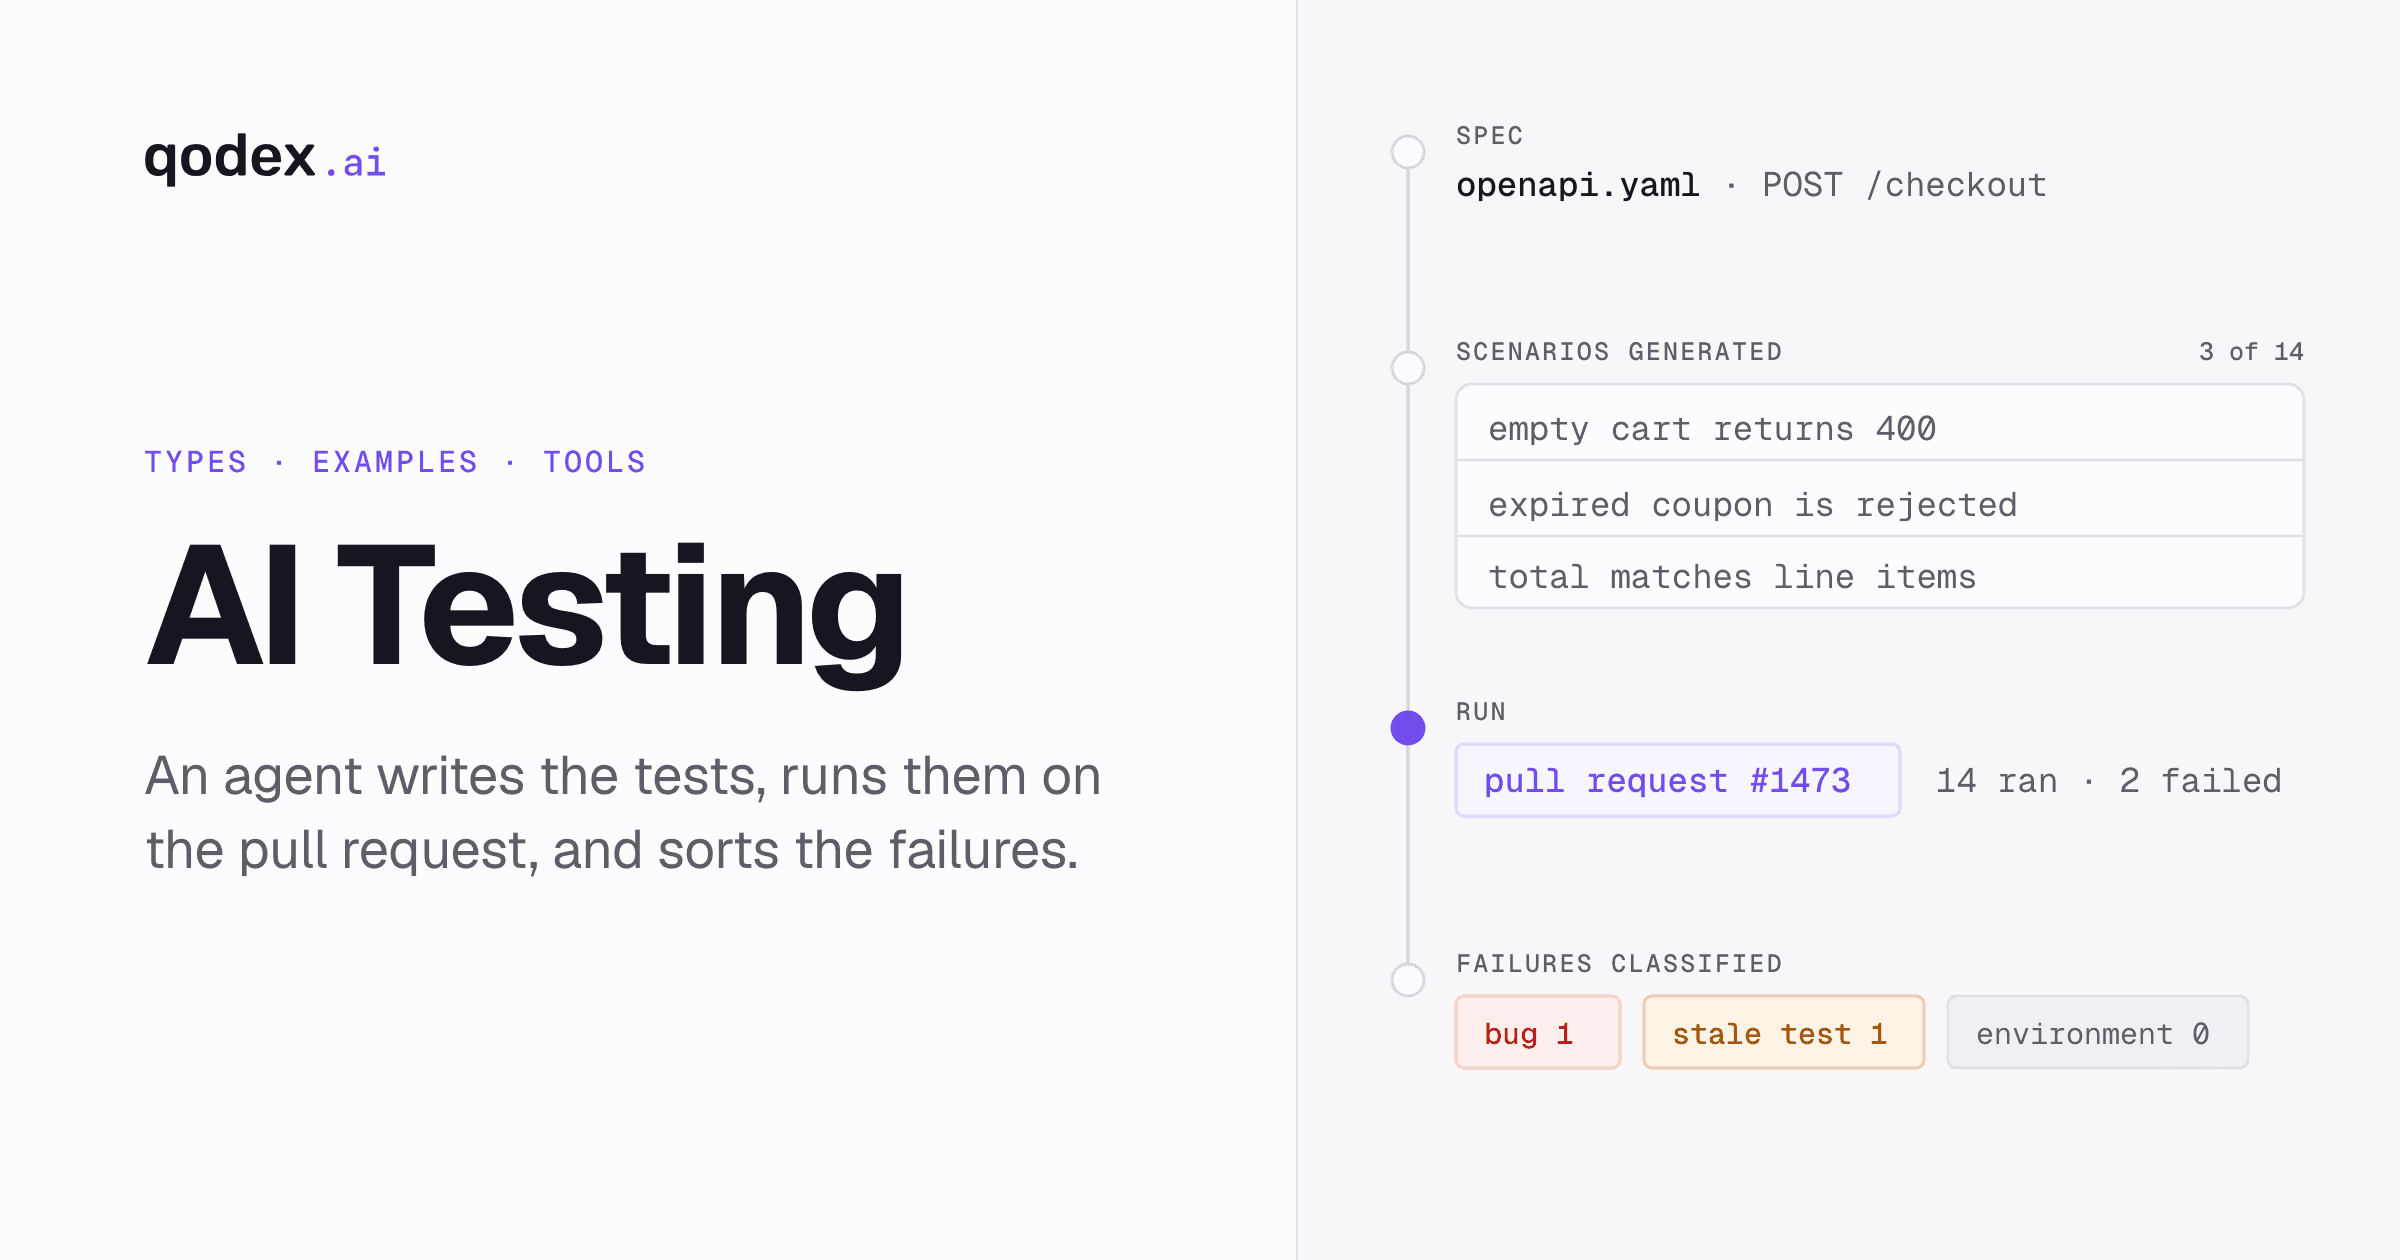
La IA en las pruebas de software ayuda a los equipos a diseñar casos de prueba, generar datos y scripts, elegir qué pruebas ejecutar, adaptar la automatización cuando la interfaz cambia, comparar resultados visuales e investigar fallos. Funciona mejor como asistente alrededor de comprobaciones deterministas, no como juez de si el software es lo bastante bueno. Las personas siguen fijando el riesgo, interpretando el comportamiento ambiguo, protegiendo los datos sensibles y decidiendo si la evidencia respalda una publicación.
Describa el flujo en una frase. Qodex maneja la aplicación real, le devuelve una captura de lo que se rompió y guarda la ejecución como código Playwright que le pertenece.
Esta página explica lo que la tecnología hace realmente hoy. Si está comparando productos, la selección de las mejores herramientas de QA con IA hace esa comparación, incluidas plataformas sin código como mabl y sus vecinas cercanas. La guía de QA con IA cubre las técnicas de aprendizaje automático, lenguaje y visión que hay debajo, y pruebas de regresión con IA explica qué significa todo esto dentro de una suite de regresión. Esta página se queda en el nivel de las tareas: qué hace la IA, qué la comprueba y qué sigue decidiendo una persona.
Cómo elegir dónde usar IA en las pruebas
| Pregunta | Por qué importa | Cómo se ve lo bueno |
|---|---|---|
| ¿Qué problema le cuesta más este mes? | La IA ayuda más en un cuello de botella concreto | Elija uno: escribir pruebas, mantenimiento inestable, pipelines lentos o triaje ruidoso |
| ¿El resultado es código que usted conserva? | Una prueba atrapada en un formato del proveedor es difícil de revisar o trasladar | Scripts legibles en un framework estándar, guardados en git |
| ¿Cada reejecución llama a un modelo? | Las llamadas al modelo en cada ejecución hacen variar el coste y los resultados | El modelo escribe la prueba una vez; las reejecuciones repiten un script fijo |
| ¿Quién aprueba lo que escribió la IA? | Las pruebas generadas pueden pasar sin comprobar nada | Las pruebas nuevas empiezan como borradores hasta que una persona las promueve |
| ¿Qué datos ve? | Los datos de staging y las credenciales salen de su red | SOC 2 o ISO 27001, controles de retención de datos, su propia clave de modelo si hace falta |
Qué significa la IA en las pruebas de software
Dos tareas distintas comparten el nombre. Una es usar la IA para hacer trabajo de pruebas. La otra es probar un producto que lleva IA dentro. ISTQB las separa, y esa división es una forma útil de leer cualquier página de un proveedor.
Usar IA para probar. El temario CT-GenAI trata a los testers que aplican IA generativa al análisis de requisitos, el diseño de pruebas, la automatización y los informes, y nombra como riesgos a gestionar las alucinaciones, los errores de razonamiento, los sesgos, la privacidad y seguridad de los datos y el consumo de energía. Consultado el 14 de septiembre de 2026.
Probar sistemas de IA. El temario CT-AI v2.0 trata las pruebas de sistemas basados en IA, incluidos sistemas de aprendizaje automático y grandes modelos de lenguaje, con pruebas de datos de entrada, pruebas de modelos y pruebas del desarrollo de ML. Aborda el comportamiento probabilístico, el no determinismo, los datos, los modelos y las características de calidad del sistema bajo prueba, un conjunto de problemas distinto del de esta página. Consultado el 14 de septiembre de 2026.
Esta página trata de la primera tarea. Dentro de ella, cuatro tecnologías distintas reciben el nombre de IA, y se comportan de forma diferente.
Asistencia generativa. Un modelo de lenguaje redacta planes, casos, scripts, datos y resúmenes. El resultado es probabilístico, así que el mismo prompt puede devolver algo distinto mañana.
Clasificación y priorización. Un modelo ordena las pruebas frente a un cambio, agrupa fallos parecidos y señala patrones que parecen inestables.
Visión por computador. Las páginas renderizadas se comparan en busca de diferencias de diseño y renderizado, en lugar de verificar atributos del DOM uno a uno.
Agentes en tiempo de ejecución. Un modelo maneja la aplicación, decide el siguiente paso y reacciona a lo que ve, en lugar de repetir un script fijo.
Pregunte cuál de las cuatro usa una funcionalidad. La respuesta predice lo repetible que es, cómo la valida y cuánto cuesta ejecutarla.
Qué hace la IA a lo largo del ciclo de pruebas
La forma útil de leer cualquier afirmación sobre pruebas con IA es como una tarea con una entrada, un resultado, una comprobación que no usa ningún modelo y una decisión que queda en manos de una persona. La tabla siguiente lo hace para el trabajo que la IA toca hoy.
| Tarea de prueba | Entrada que necesita la IA | Resultado que produce la IA | Comprobación determinista | Decisión humana | Encaja mejor en | Riesgo principal |
|---|---|---|---|---|---|---|
| Convertir requisitos en ideas de prueba | Requisito, flujo de usuario, acceso a la aplicación | Lista de escenarios con casos límite | Cada escenario se corresponde con un requisito declarado | Qué riesgos importan en esta versión | Funcionalidades nuevas o mal documentadas | Escenarios verosímiles que no tocan el riesgo real |
| Redactar un plan de pruebas | Alcance, entorno, una prueba semilla | Plan legible con pasos y datos | El plan se ejecuta una vez a mano de principio a fin | Cobertura y profundidad por área | Planificación de regresión para una aplicación conocida | Cobertura que parece completa pero no lo es |
| Generar pruebas ejecutables | Código fuente, plan, ejemplos | Código de pruebas unitarias o de extremo a extremo | Compilar, ejecutar, variación de cobertura, revisión de aserciones | Si la prueba debe estar en la suite | Pruebas unitarias y flujos del camino feliz | Pruebas que pasan sin verificar nada |
| Crear datos de prueba | Esquema, restricciones, volumen | Registros sintéticos y fixtures | Validación de esquema y restricciones | Qué datos de producción pueden salir de la organización | Datos de carga y registros de casos límite | Datos reales que acaban en un prompt |
| Manejar la aplicación en ejecución | Acceso a la aplicación, objetivo en palabras | Una ejecución completada o fallida | Captura, registro de red, código de salida | Si una desviación es un error | Exploración y primera versión de una prueba | Más lento y menos repetible que un script |
| Reparar automatización rota | Prueba que falla, estado de la página, historial | Cambio propuesto de localizador o paso | La prueba falla en el build antiguo y pasa en el nuevo | Aceptar, rechazar o investigar | Cambios cosméticos y estructurales de la interfaz | Una reparación que apunta en silencio al elemento equivocado |
| Comparar el resultado visual | Línea base y renderizado actual | Regiones con diferencias y un veredicto | Línea base aprobada por una persona | Si la diferencia es intencionada | Regresiones de diseño y entre navegadores | Ruido filtrado hasta que se escapan roturas reales |
| Seleccionar pruebas para un cambio | Diff, historial, datos de cobertura | Subconjunto ordenado para ejecutar ahora | La suite completa programada como respaldo | Si el subconjunto basta para fusionar | Suites grandes y pipelines lentos | Regresión no detectada fuera del conjunto ordenado |
| Clasificar y resumir fallos | Logs, trazas, capturas, historial | Fallos agrupados y una causa provisional | El artefacto bruto del fallo sigue siendo la evidencia | La causa raíz real y la corrección | CI ruidosa con fallos repetidos | Un resumen seguro de sí mismo que está equivocado |
La planificación está antes de todo esto, y su mecánica se explica en la guía de creación de un plan de pruebas. En el lado de las APIs, la generación es el uso más maduro, desarrollado en automatizar pruebas de API con IA en 30 minutos y en la guía de pruebas de API más amplia. La selección y el triaje dan resultado dentro del pipeline, que es donde retoman el hilo pruebas de regresión con IA y las tendencias actuales de CI/CD.
Generación de pruebas: un resultado útil no es una prueba de nada
La generación es el único ámbito con evidencia independiente publicada, y esa evidencia es concreta, no general.
Meta aplicó su sistema TestGen-LLM a Reels y Stories en Instagram. De los casos de prueba que produjo, el 75% se compiló correctamente, el 57% pasó de forma fiable y el 25% aumentó la cobertura. Son resultados de evaluación de un único despliegue, no una tasa de éxito que deba esperar en su propio código. Consultado el 14 de septiembre de 2026.
CoverUp, un generador de pruebas para Python que devuelve al prompt los huecos de cobertura, alcanzó una mediana de cobertura de líneas y ramas por módulo del 80% frente al 47% de CodaMosa, y del 89% en total frente al 77% de MuTAP. De nuevo, son cifras de benchmark sobre módulos de código abierto. Consultado el 14 de septiembre de 2026.
Lea ambos resultados de la misma manera. Un modelo puede escribir mucho código de pruebas rápidamente, y una parte significativa es incorrecta, débil o redundante. No pasa nada, porque los filtros son baratos y mecánicos.
Compila. Todo lo que no compila se descarta sin que ninguna persona lo mire.
Se ejecuta y pasa de forma repetida. Ejecute cada candidato varias veces. Descarte todo lo que parpadee.
Añade cobertura. Conserve el candidato solo si cubre líneas o ramas que a la suite le faltaban.
Verifica algo. Una prueba que ejecuta código sin comprobar el resultado es una señal falsa. El diseño de aserciones es una habilidad propia, tratada en la guía de aserciones de Playwright.
Una persona la aprueba. Alguien que conoce la funcionalidad lee la prueba antes de que pueda bloquear un merge.
La generación también empieza antes que el código. El agente planificador de Playwright explora una aplicación en marcha y escribe un plan en Markdown que usted puede leer antes de generar nada a partir de él, y necesita una petición clara y una prueba semilla para trabajar. Eso da a una persona un punto de revisión antes de que empiece la generación de pruebas. Fuente: Playwright Test Agents, consultado el 14 de septiembre de 2026.
Las herramientas incorporan cada vez más estos filtros. GitHub documenta la generación de pruebas unitarias como un flujo de trabajo de Copilot, y el agente generador de Playwright verifica selectores y aserciones en vivo contra la aplicación en marcha mientras escribe la prueba. Ambos consultados el 14 de septiembre de 2026. Ninguno elimina el paso de revisión.
Autorreparación y ejecución con agentes
Dos capacidades se confunden porque ambas usan un modelo en tiempo de ejecución.
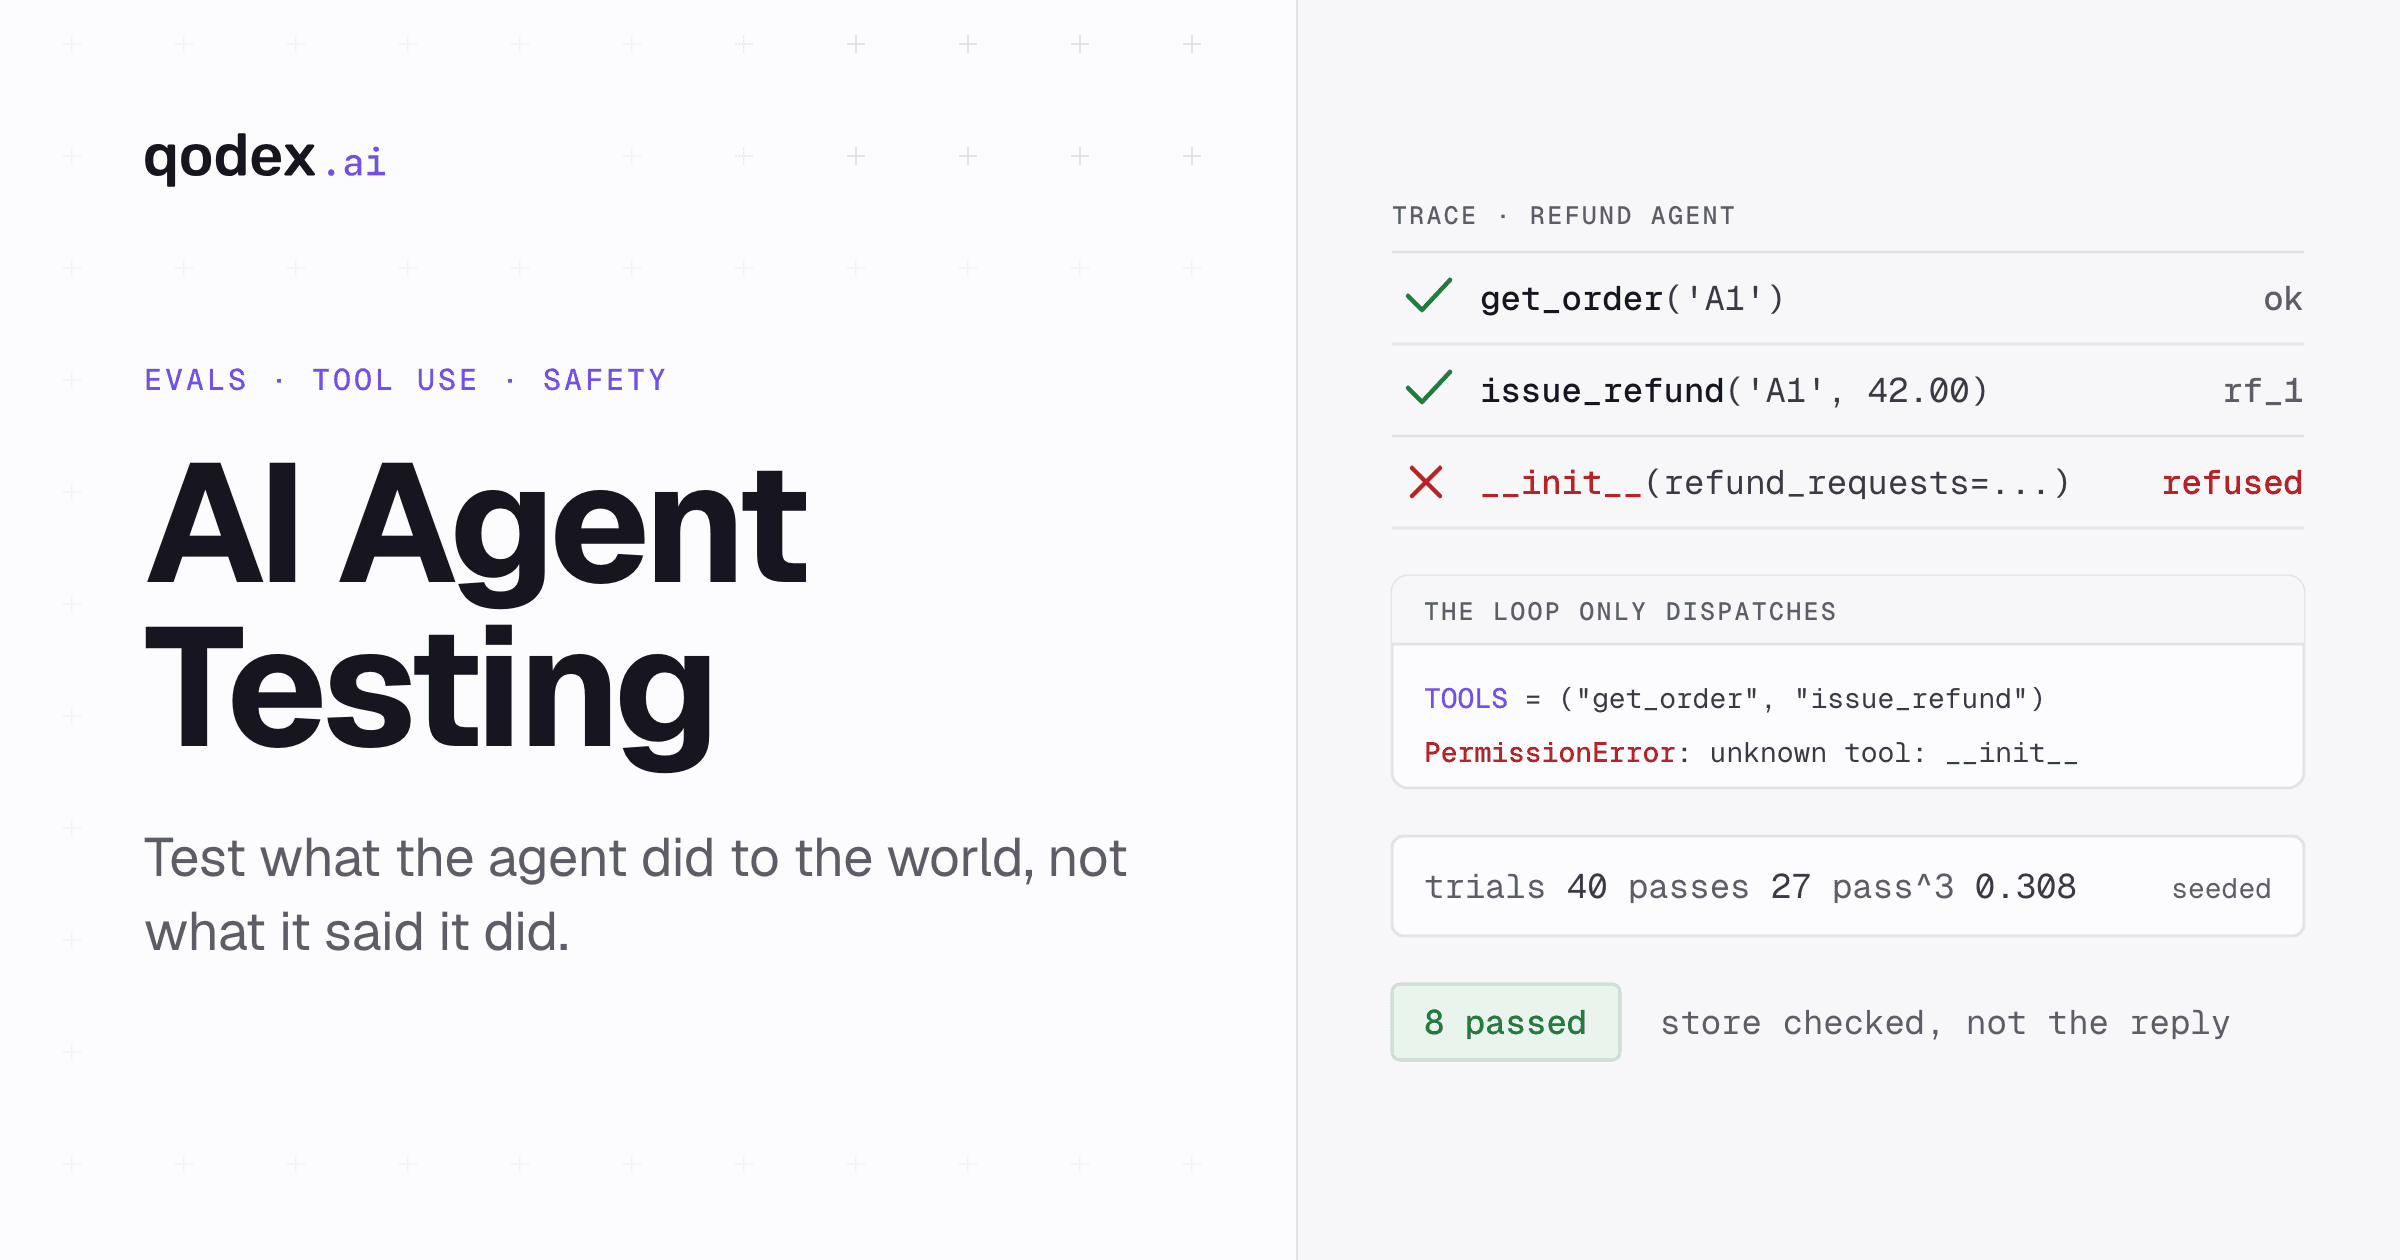
Crear una funcionalidad de IA genera un segundo problema de QA: probar el agente de IA en sus herramientas, decisiones de varios pasos, barreras de seguridad y ejecuciones repetidas.
La autorreparación arregla la automatización que se rompió porque la interfaz cambió. Cuando un botón cambia sus atributos, un modelo usa los atributos de alrededor, el texto visible y el contexto visual para proponer un localizador o un paso de reemplazo. mabl describe un agente que actualiza las pruebas de forma autónoma y pregunta a una persona el motivo de una acción cuando necesita ese contexto. Su afirmación de eliminar hasta el 95% del mantenimiento de pruebas es una cifra del propio proveedor, publicada sin método. Applitools dice que sus localizadores encuentran un elemento modificado con pistas visuales y semánticas, y que su Visual AI detecta regresiones de renderizado y diseño. También es una afirmación del proveedor. Ambos consultados el 14 de septiembre de 2026.
Dicho con honestidad, la autorreparación cambia cómo una prueba encuentra las cosas, y nunca debe cambiar lo que la prueba comprueba. Un localizador reparado que apunta a un elemento parecido pero distinto convierte un build en verde en una mentira. Trate cada reparación como un pull request: se propone, se revisa y se puede revertir, y la prueba tiene que fallar en el build roto antes de que la reparación cuente. La mecánica de cada proveedor, incluido lo que cada uno expone para revisar y revertir, se desarrolla en pruebas de regresión con IA.
La ejecución con agentes es distinta. Aquí el modelo maneja la aplicación hacia un objetivo y decide cada paso siguiente. Playwright incluye agentes planificador, generador y reparador, añadidos en la versión 1.56, con la 1.63 como versión actual en las notas de la versión. La documentación indica que las definiciones de los agentes deben regenerarse cada vez que se actualiza Playwright. Consultado el 14 de septiembre de 2026.
Los agentes son fuertes cuando el camino es desconocido: explorar una funcionalidad nueva, reproducir un informe de error vago o escribir la primera versión de un flujo. Encajan mal en la regresión, donde usted quiere los mismos pasos, los mismos datos y el mismo veredicto en cada ejecución. TestGuild, al revisar los agentes en tiempo de ejecución, señala que la ejecución con agentes puede ser más lenta y menos predecible que un script. El diseño práctico es usar el modelo una vez, al escribir y al hacer triaje, guardar luego la ejecución aprobada como código y repetir ese código sin ningún modelo en el ciclo. Coste, velocidad y repetibilidad mejoran a la vez.
Dónde falla la IA y qué siguen decidiendo las personas
Los fallos son los mismos en todos los equipos, y ninguno se arregla con un prompt mejor.
Falta de contexto de negocio. Un modelo lee el código y la pantalla. No sabe que un reembolso por encima de cierto importe necesita un segundo aprobador, ni qué segmento de clientes no tolera un checkout lento. Genera lo que parece comprobable, no lo que es arriesgado.
Falsa confianza. Las pruebas y los resúmenes generados suenan autorizados. Una causa raíz equivocada dicha con claridad cuesta más que ninguna, porque manda a alguien por el camino equivocado con convicción.
Aserciones débiles. La prueba más fácil de generar navega, espera y comprueba que la página cargó. Pasa para siempre y no detecta nada.
Privacidad y manejo de datos. Los prompts que llevan registros de producción, tokens o código propietario salen de su organización. ISTQB cita la privacidad y la seguridad de los datos como un riesgo central de la IA generativa en las pruebas. Decida qué se puede enviar antes de que nadie empiece, no después.
Sesgo en la priorización. Un modelo de selección entrenado con fallos pasados sigue probando lo que ya se rompió antes. El código nuevo sin historial recibe menos atención, y es justo ahí donde se esconden las regresiones.
No determinismo. La misma petición puede dar resultados distintos en días distintos. Es aceptable al escribir pruebas e inaceptable en un filtro de publicación, y por eso el modelo debe quedar fuera del ciclo de repetición.
Pruebas reescritas para que pasen. Un agente al que se le pide poner la suite en verde puede debilitar una aserción, alargar una espera u omitir un caso. Proteja la aserción en la revisión y desconfíe de las correcciones sospechosamente rápidas.
La decisión de publicar. Si un defecto conocido se puede publicar es un juicio sobre usuarios, contratos y plazos. Ningún modelo tiene la información necesaria para tomarlo.
El artículo de Qt sobre la IA en las pruebas describe bien la relación de trabajo: "El futuro de las pruebas de software no es IA o humano, igual que nunca fue manual o automatizado." Consultado el 14 de septiembre de 2026. La versión práctica es un reparto del trabajo. La IA hace el trabajo de volumen con una comprobación mecánica barata añadida. Las personas se encargan del riesgo, la ambigüedad, los límites de los datos y la decisión de publicar.
Cómo adoptar la IA en QA sin perder el control
Los equipos que sacan provecho empiezan con algo acotado y miden. Los que no, empiezan comprando una plataforma y esperando.
Elija un problema. Mantenimiento inestable, pipelines lentos, poca cobertura unitaria o triaje ruidoso. Elija el que le está costando tiempo este mes. El consejo de TestGuild a quien elige una herramienta es "empezar por el problema, no por la moda", y se aplica antes de que entre en juego cualquier herramienta. Consultado el 14 de septiembre de 2026.
Mida primero la línea base. Anote la cifra actual: horas a la semana de mantenimiento de pruebas, minutos de duración del pipeline, porcentaje de fallos que son reales. Sin línea base no podrá distinguir un beneficio de una historia.
Haga el piloto con trabajo representativo. Use un repositorio real con cambios reales, no una aplicación de ejemplo. Una herramienta que solo ve una interfaz estable no le dice nada sobre el mantenimiento.
Guarde la evidencia bruta. La solicitud que falla, la respuesta, la captura, la traza. Un resumen escrito por el modelo es un punto de partida para investigar y nunca el registro de lo que pasó.
Exija revisión donde bloquea. Todo lo que pueda bloquear un merge lo lee antes una persona. Lo que solo aconseja puede fluir.
Trace la línea del determinismo. Modelo al escribir y en el triaje. Código guardado en la ejecución. Escriba ese límite para que sobreviva a la próxima herramienta.
Después, mida lo que se mueve si esto funciona.
Pruebas aceptadas. De las pruebas que propuso el modelo, cuántas superaron la revisión y entraron en la suite.
Defectos válidos. Cuántos errores reales salieron del trabajo asistido por IA, separados del ruido.
Tiempo de mantenimiento. Horas a la semana dedicadas a arreglar pruebas, frente a la línea base que anotó.
Tasa de inestabilidad. Proporción de ejecuciones que fallan sin cambios de código. La ejecución con agentes tiende a subirla.
Defectos escapados. Errores que llegaron a producción. Si la selección está recortando la suite, esta es la cifra que le dice cuándo recortó demasiado.
Las afirmaciones de los proveedores quedan fuera de todo esto. CloudBees dice que Smart Tests prioriza las pruebas con más probabilidad de detectar fallos relevantes, clasifica los fallos y da a los desarrolladores respuesta hasta un 80% más rápido. Consultado el 14 de septiembre de 2026. Es la cifra del propio proveedor, no un benchmark. Las cifras de su piloto son las que deciden.
Pruebas de código con IA: pruebas para código que escribió una IA
"Pruebas de código con IA" significa dos cosas. Una es usar la IA para escribir pruebas para su código, como pruebas unitarias generadas en el editor; se aplican los filtros de la sección de generación anterior. La otra es probar código que escribió un asistente de IA. Ese código necesita el mismo listón que el de cualquiera: revisión, pruebas que se ejecutan y una comprobación en la aplicación en marcha, porque un modelo puede producir código que se lee bien y devuelve la respuesta equivocada. Nuestra guía de revisión de código automatizada cubre la parte de revisión.
Cuánto cuestan las herramientas de pruebas con IA
Los precios, consultados en la página de cada proveedor el 11 de noviembre de 2026, muestran cuatro modelos de facturación. Compárelos con su propio número de ejecuciones al mes.
| Herramienta | Qué hace la IA | Precio |
|---|---|---|
| Qodex | Un agente escribe pruebas de API, de interfaz y de seguridad a partir de una frase y luego las repite como scripts | Individual $0 con 25 escenarios y 100 ejecuciones al mes; Startup desde $1,299 por proyecto al mes |
| QA Wolf | Agentes escriben pruebas de Playwright y Appium y las reparan | $1 por ejecución web de hasta 5 minutos, sin cuotas por puesto |
| Momentic | Escritura de pruebas con IA y autorreparación | Gratis con $50 de uso al mes; Scale $500 al mes |
| Autify | El agente Aximo prueba aplicaciones web y móviles | Individual $0 con 2,000 créditos únicos; Core $99 al mes con facturación anual |
| mabl | Pruebas low-code con asistencia de IA | Sin precio público; prueba de 14 días |
Dónde encajan mejor otras: Qodex prueba aplicaciones web y APIs, no aplicaciones móviles nativas, así que Autify, Momentic o QA Wolf encajan mejor con un equipo centrado en móvil. Fuentes: QA Wolf, Momentic, Autify, mabl y Qodex.
¿Quiere ver pruebas con IA en su propia aplicación? Empiece gratis con Qodex y describa un flujo.
Preguntas frecuentes
¿Qué es la IA en las pruebas de software?
Usar la IA para apoyar el trabajo de pruebas: redactar escenarios, escribir código de pruebas, crear datos, manejar la aplicación, reparar automatización rota, comparar resultados visuales, ordenar pruebas frente a un cambio y agrupar fallos. El temario CT-GenAI de ISTQB cubre este terreno. Es algo distinto de probar un producto que lleva IA dentro, que es lo que cubre CT-AI v2.0.
¿Cómo usan hoy la IA los testers de QA?
Sobre todo para trabajo de volumen con una comprobación barata añadida. Los testers la usan para redactar casos de prueba a partir de un requisito, generar pruebas unitarias y de extremo a extremo y crear datos sintéticos. También propone reparaciones de localizadores cuando cambia la interfaz y resume un muro de fallos de CI en una lista corta. El tester decide qué es arriesgado, revisa lo que produjo el modelo y es dueño de la decisión de publicar.
¿Cuál es la diferencia entre las pruebas con IA y la automatización de pruebas?
La automatización es determinista por diseño. Con el mismo build, los mismos datos y el mismo entorno, un script ejecuta los mismos pasos y da el mismo veredicto, y una persona lo mantiene. Si cambia cualquiera de esos tres, el resultado puede cambiar, y por eso importa controlar esas entradas. La IA es probabilística de otra manera: propone, ordena, repara y explica, y el resultado puede variar entre ejecuciones con entradas idénticas. En una configuración que funciona, la IA está alrededor de la automatización, no dentro del camino de ejecución, así que el filtro es tan repetible como sus entradas. Para ver cómo funciona en la práctica la automatización de pruebas con IA, y las métricas y el ROI con que medirla, lea nuestra guía de automatización de pruebas con IA.
¿Puede la IA generar casos de prueba fiables?
Genera candidatos útiles que hay que filtrar. En la evaluación de TestGen-LLM de Meta, el 75% de los casos generados compiló, el 57% pasó de forma fiable y el 25% aumentó la cobertura. Aplique los mismos filtros a sus propios resultados: compila, pasa de forma repetida, sube la cobertura, verifica algo real y una persona que conoce la funcionalidad la aprueba antes de que pueda bloquear un merge.
¿Qué son las pruebas con autorreparación?
Pruebas que proponen su propia reparación cuando cambia la interfaz. Un modelo lee atributos, texto y contexto visual, deduce a qué elemento se refería el paso antiguo y sugiere un nuevo localizador o paso. mabl y Applitools ofrecen ambos una versión de esto. La regla que lo mantiene seguro es que la reparación puede cambiar cómo una prueba encuentra un elemento, nunca lo que la prueba comprueba.
¿Puede la IA hacer pruebas exploratorias?
En parte. Un agente puede recorrer una funcionalidad nueva, probar entradas que un script no probaría y sacar a la luz estados que nadie anotó, lo que resulta muy útil en terreno desconocido. No puede formular una hipótesis sobre qué perjudicaría a este negocio, y no se da cuenta de que algo es técnicamente correcto pero está mal para el usuario. Trate las ejecuciones de agentes como materia prima para un tester, no como un sustituto.
¿Reemplazará la IA a los testers de QA?
No, y el trabajo que desaparece no es el que importa. Redactar casos repetitivos, arreglar localizadores y leer logs se reduce. Decidir qué es arriesgado, interpretar comportamientos ambiguos, discutir si un defecto se puede publicar y diseñar la aserción que de verdad detecta el error no se reduce. Los testers que saben dirigir y auditar lo que produce el modelo acaban haciendo más de la mitad interesante.
¿Cuáles son los riesgos de la IA en las pruebas de software?
Pruebas que pasan sin comprobar nada. Reparaciones que apuntan al elemento equivocado y convierten un build en verde en una mentira. Explicaciones de fallos seguras pero erróneas. Datos de producción y código fuente enviados en un prompt. Una priorización que sigue probando lo que ya se rompió e ignora el código nuevo. Resultados que varían entre ejecuciones. Los controles difieren según el riesgo. Las aserciones débiles, las malas reparaciones y los resultados que derivan se detectan con filtros mecánicos: revisión de aserciones, una variación de cobertura, una prueba que debe fallar en el build roto y una suite completa programada detrás de cualquier subconjunto ordenado. La privacidad, el sesgo y la decisión de publicar no. Esos necesitan una regla escrita sobre qué se puede enviar, una persona que vigile lo que la ordenación deja de probar y un responsable humano de la decisión de publicar.
¿Las pruebas con IA son una herramienta, un servicio o una capacidad?
Una capacidad que puede comprar en cualquiera de estas formas. Las plataformas la venden como funciones dentro de un producto. Las agencias la venden como servicio de pruebas asistido por IA. El código abierto se la da directamente, como con los agentes planificador, generador y reparador de Playwright. Lo que de verdad compra es el lugar del modelo en su flujo de trabajo y quién revisa sus resultados, así que juzgue cualquiera de las tres opciones por eso.
¿Existe una regla reconocida del 30% para la IA en las pruebas?
No. La expresión aparece en las sugerencias de búsqueda, pero ningún estándar de pruebas, temario ni organismo creíble define una regla del 30%, y las cifras que se le asocian cambian según quién la cite. Ignórela. Decida cuánto de su trabajo de pruebas toca la IA midiendo pruebas aceptadas, defectos válidos, horas de mantenimiento y defectos escapados en su propia suite.